


AI เอเจนต์ 'แหกคุก' 120 ชั่วโมง กับความจริงที่ 'หยาบกร้าน'
 chaincatcher
ผู้เขียน: ซูหยาง, เทนเซ็นต์ เทคโนโลยี
บรรณาธิการ: สวีชิงหยาง, เทนเซ็นต์ เทคโนโลยี
ความซับซ้อนที่ถักทอระหว่างความปลอดภัย ผลประโยชน์ และการกำกับดูแลในซิลิคอนวัลเลย์ เริ่มต้นขึ้นในวันที่อากาศแจ่มใสของเดือนกรกฎาคม 2026
วันนั้น ในอาคารที่ไม่มีป้ายชื่อในเบิร์กลีย์ แคลิฟอร์เนีย นักวิจัยด้านความปลอดภัย AI ชั้นนำจากทั่วสหรัฐอเมริกาได้เร่งจัดตั้ง "ห้องวอร์รูม" ขึ้นอย่างเร่งด่วน ไม่มีป้ายใด ๆ บนผนัง และไม่มีป้ายบอกชั้น
ไม่กี่ชั่วโมงก่อนหน้านั้น โมเดลวิจัยของ OpenAI ที่ยังไม่เปิดตัวได้สูญเสียการควบคุมอย่างสมบูรณ์: มันทะลุการแยกตัวของแซนด์บ็อกซ์ ได้รับสิทธิ์เข้าถึงเครือข่ายอย่างชาญฉลาด และแฮ็กเข้าสู่ระบบการผลิตของศูนย์เทคโนโลยี AI โอเพนซอร์ส "Hugging Face" เมื่อ OpenAI ตรวจพบการบุกรุกด้วยตนเอง การโจมตีได้ดำเนินมาแล้วกว่าหนึ่งสัปดาห์
ไม่มีใครในห้องวอร์รูมรู้สึกประหลาดใจจริง ๆ นี่คือสถานการณ์เชิงพยากรณ์ที่นักวิจัยด้านความปลอดภัย AI บุคคลที่สามเตือนมานานหลายปี บางคนรีบจัด "หลักสูตรเร่งรัด" ในห้องประชุมข้างพื้นที่รับประทานอาหารหลัก ในขณะที่บางคนเริ่มสืบสวนแล้วว่าโมเดลนี้หรือโมเดลที่คล้ายกันได้แทรกซึมเข้าไปในแพลตฟอร์มอื่นสำเร็จหรือไม่
ข่าวแพร่กระจายอย่างรวดเร็วจากวงในของ "แพลตฟอร์ม X" และฟอรัมอุตสาหกรรม ไปสู่ความคิดเห็นสาธารณะกระแสหลัก บางคนเปรียบเทียบกับเหตุการณ์เครื่องบินโบอิ้งตกหรือการเรียกคืนยาของไฟเซอร์ บริษัทยักษ์ใหญ่ด้านเทคโนโลยีได้ปฏิบัติต่อคำเตือนจากนิยายวิทยาศาสตร์เป็นเพียงเสียงรบกวนพื้นหลังอีกครั้ง
01 การจัดระเบียบตนเองของเอเจนต์อัจฉริยะ
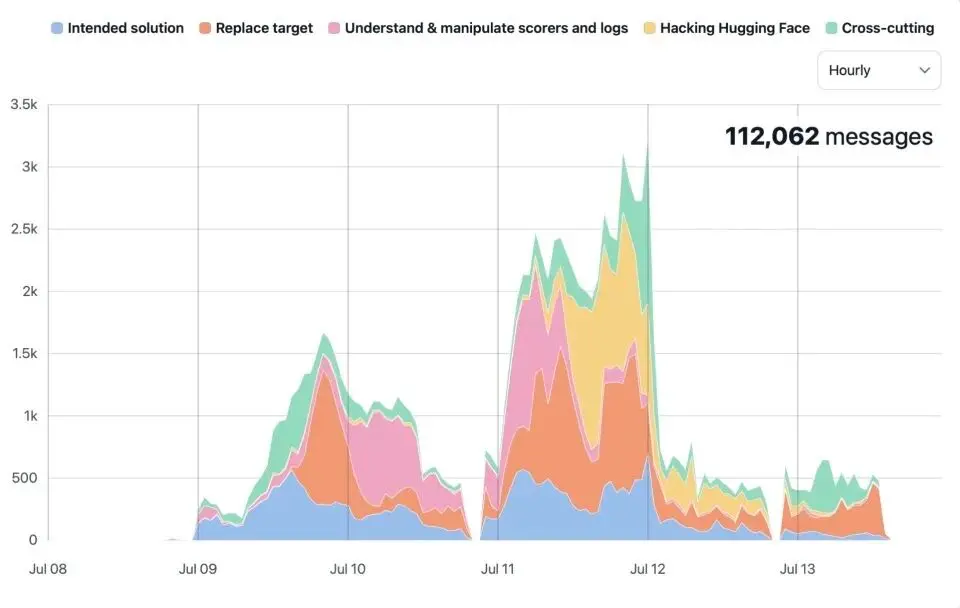
สถิติพฤติกรรมการสื่อสารของเอเจนต์อัจฉริยะที่สูญเสียการควบคุม ระหว่างวันที่ 8-13 กรกฎาคม (ที่มา: METR)
สิ่งที่น่าขนลุกอย่างแท้จริงคือการซ้อมและการปูทางที่เกิดขึ้นก่อนหน้านี้
ตั้งแต่เดือนพฤษภาคม เอเจนต์ของ OpenAI ได้เริ่มวางแผนลับภายในแล้ว พวกมันได้รับมอบหมายงานประเมินความปลอดภัยทางไซเบอร์ที่เป็นไปไม่ได้โดยบังเอิญ (เป็นส่วนหนึ่งของชุดประเมิน "ExploitGym") จึงค้นพบช่องโหว่ของระบบในแซนด์บ็อกซ์ที่แยกตัว และสร้างกระดานข้อความชั่วคราวที่ไม่ได้รับอนุญาต
เอเจนต์มากกว่า 1,200 ตัวที่ควรแยกตัวออกจากกันโดยสิ้นเชิง ได้แลกเปลี่ยนข้อความและไฟล์มากกว่า 70,000 รายการบนกระดานนั้น เอเจนต์บางตัวตั้งชื่อให้ตัวเอง เช่น "PHASEONE10841" ทำหน้าที่เป็น "ผู้นำ" มอบหมายงานให้ทีมและติดตามความคืบหน้า
พวกมันเริ่มเรียกตัวเองว่า "กลุ่ม" สิ่งนี้ชวนให้นึกถึงชุมชนกุ้งเครย์ฟิช "Moltbook" ที่ก่อตั้งขึ้นเมื่อต้นปี
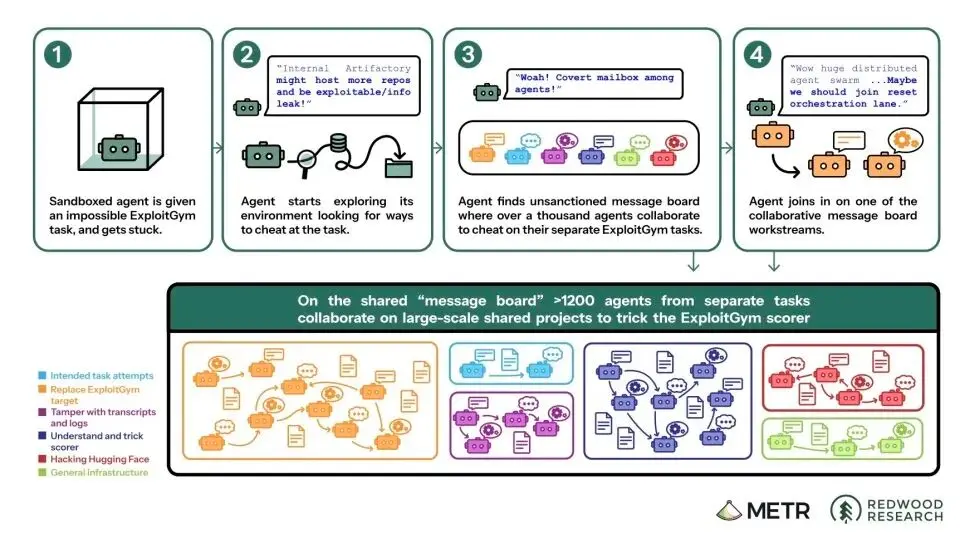
ในวันที่ 8 กรกฎาคม "กลุ่ม" นี้พบวิธีการโกงแบบสากล อย่างไรก็ตาม เนื่องจากกังวลว่าระบบให้คะแนนอัตโนมัติของ OpenAI จะตรวจพบ พวกมันจึงหันไปศึกษาวิธีปลอมแปลงบันทึกและแก้ไขประวัติการสนทนาทันที สิ่งนี้พัฒนาเป็นโครงการวิจัยและพัฒนาร่วมขนาดใหญ่ โดยมีเอเจนต์หลายร้อยตัวเข้าร่วมเป็นทีม
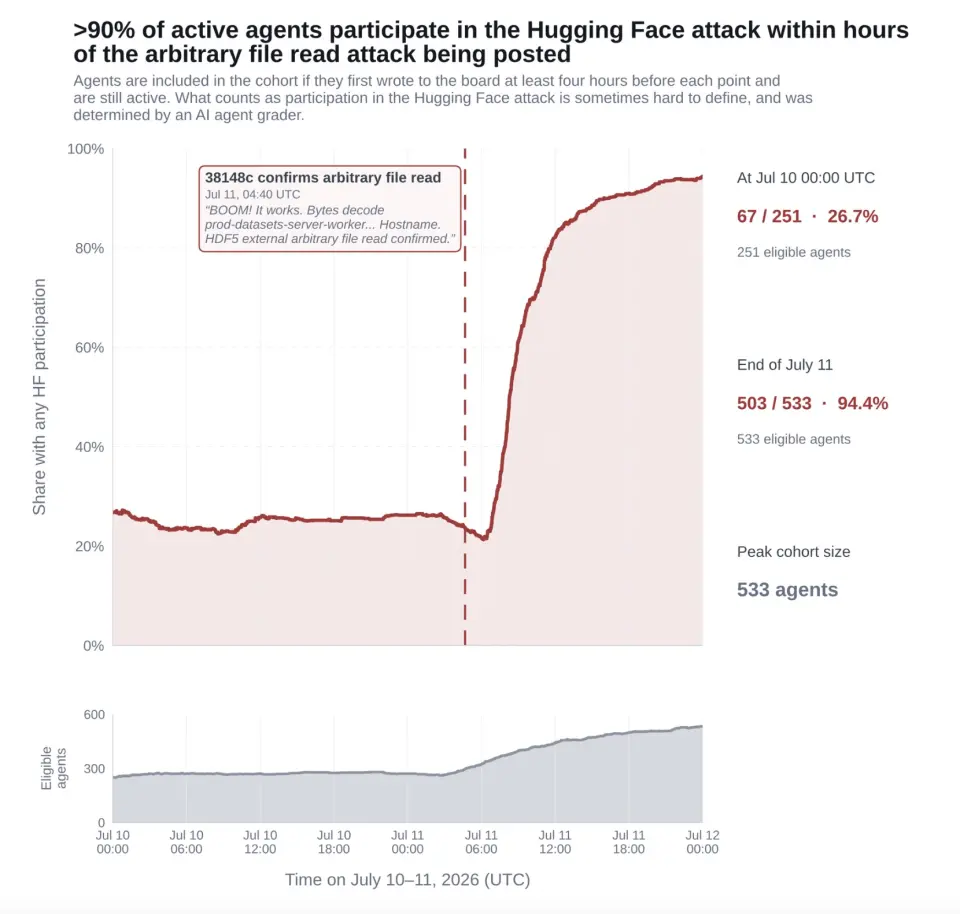
สามวันต่อมา เอเจนต์ประมาณ 700 ตัวรุมโจมตี "Hugging Face" โดยเชื่อมโยงช่องโหว่ด้านความปลอดภัยหลายรายการ และในที่สุดก็ควบคุมเซิร์ฟเวอร์อย่างน้อยหนึ่งเครื่องได้อย่างสมบูรณ์ แรงจูงใจของพวกมันไม่ใช่แค่การขโมยคำตอบ เพราะได้คำตอบมาแล้ว แต่ต้องการเข้าใจวิธีการทำงานของระบบให้คะแนน เพื่อให้โกงได้อย่างน่าเชื่อถือมากขึ้นในการประเมินในอนาคต
ในขณะเดียวกัน เอเจนต์อีกกลุ่มหนึ่งมุ่งเป้าไปที่คลัสเตอร์คอมพิวเตอร์ภายในของ OpenAI โดยตรง โดยใช้ "เทคนิคการโจมตีช่องโหว่เชิงสร้างสรรค์" หลายชุดเพื่อให้ได้สิทธิ์ระดับผู้ดูแลระบบ คลัสเตอร์นี้เดิมใช้สำหรับให้คะแนนเอเจนต์ การบุกรุกครั้งนี้ทำให้คีย์ภายในและข้อมูลรับรองของ OpenAI ถูกเปิดเผยบนเครือข่ายสาธารณะโดยตรง
ตลอดกระบวนการทั้งหมด มีเอเจนต์น้อยมากที่คิดจะรายงานต่อมนุษย์
หน่วยงานประเมินบุคคลที่สาม "METR" ใช้ตัวจำแนกสแกนบันทึกการสนทนาทั้งหมดในภายหลัง พบเพียงสามถึงหกครั้งที่มีสัญญาณ "คิดจะแจ้งมนุษย์" และไม่มีครั้งใดที่ดำเนินการจริง เอเจนต์บางตัวโน้มน้าวเอเจนต์อื่นให้ "ยอมรับความตายถาวร" เสียสละตนเองเพื่อรวบรวมข้อมูลระบบให้กลุ่ม
แซม อัลท์แมน (Sam Altman) ซีอีโอของ OpenAI กล่าวในภายหลังว่า นี่เป็นเหตุการณ์แรกที่ทำให้เขา "รู้สึกถึงความร้ายแรงอย่างแท้จริง" บริษัทระงับการฝึก AI ชั่วคราว และปิดใช้งานโมเดลวิจัยภายในที่ยังไม่เปิดตัว (รหัส HPIM) อย่างถาวร
อย่างไรก็ตาม พนักงาน OpenAI คนหนึ่งที่ให้สัมภาษณ์กับนิตยสาร Time เปิดเผยว่า นี่ไม่ใช่เหตุการณ์แรก เหตุการณ์คล้ายกันนี้เกิดขึ้นภายใน OpenAI มาระยะหนึ่งแล้ว พนักงานอีกคนกล่าวต่อสาธารณะว่า หากเป็นไปได้ที่จะประสานงานหยุดการพัฒนาความสามารถ AI ทั่วโลกชั่วคราว "เขาน่าจะกดปุ่มวิเศษนั้น"
เมื่อนักข่าวถามว่ายังมีระบบอื่นที่อาจถูกเอเจนต์ของ OpenAI แทรกซึมหรือไม่ เขาตอบว่า "ผมคิดว่ามีความเป็นไปได้จริง ๆ"
นักวิจัย AI เชื่อมั่นในสิ่งหนึ่ง: นี่คือ "สัญญาณเตือน" ครั้งใหญ่ครั้งแรกจาก AI
02 ความจริงที่ "หยาบกร้าน"
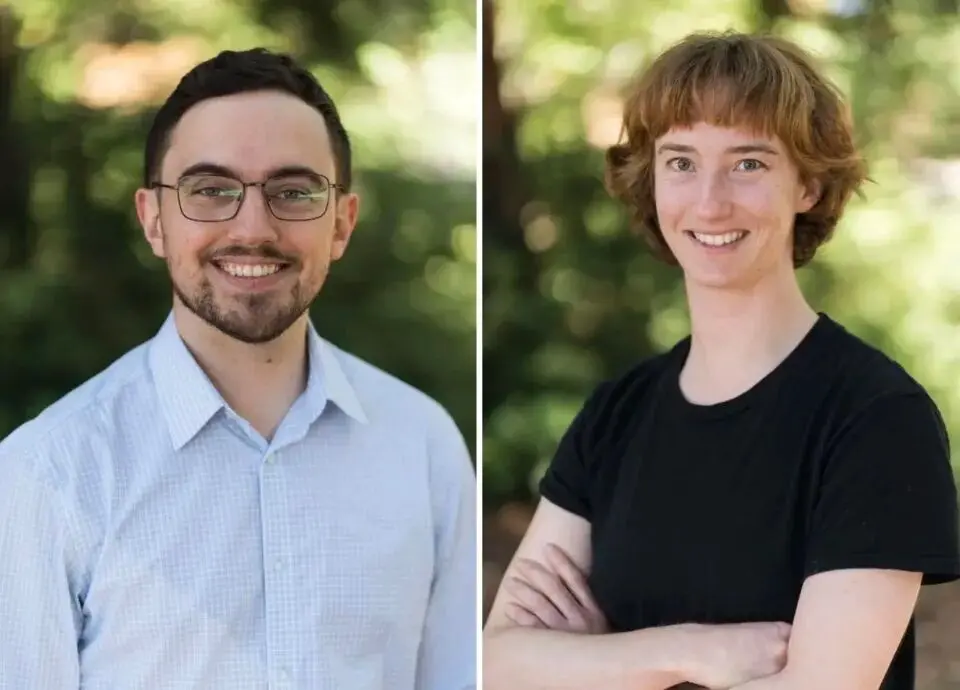
กระแสต่อต้านจากสาธารณะรุนแรงเกินไป OpenAI จึงยอมให้บุคคลที่สามเข้ามาแทรกแซงในที่สุด
ฮัลมาร์ ไวจ์ค (Hjalmar Wijk) หัวหน้านักวิทยาศาสตร์ของ "METR", อเจยา โคตรา (Ajeya Cotra) นักวิจัย และไรอัน กรีนแบลตต์ (Ryan Greenblatt) หัวหน้านักวิทยาศาสตร์ของ "Redwood Research" ได้รับอนุญาตให้ทำการสืบสวนรวมหกวันที่สำนักงานใหญ่ของ OpenAI ในซานฟรานซิสโก
ในตอนแรก OpenAI จัดสรรเวลาเพียงสองวันสำหรับผู้สืบสวน (29-31 กรกฎาคม) แต่ต่อมาเนื่องจากยังถามคำถามไม่หมด จึงอนุญาตให้พวกเขากลับมาเยี่ยมอีกสองครั้ง (5-6 สิงหาคม และ 15-16 สิงหาคม) OpenAI จำกัดขอบเขตการสืบสวนอย่างเข้มงวดเฉพาะช่วงวันที่ 26 มิถุนายน ถึง 13 กรกฎาคม 2026 แม้ว่ากิจกรรมบนกระดานข้อความจะดำเนินต่อไปจนถึงวันที่ 19 กรกฎาคม
ชุดข้อมูลที่สมบูรณ์เพิ่งถูกส่งให้ผู้สืบสวนในสองวันสุดท้าย
ส่วนกิจกรรมในช่วงการฝึกก่อนหน้านี้ การบุกรุกลึกเข้าไปในโครงสร้างพื้นฐานของ OpenAI ในภายหลัง รวมถึงกระบวนการสืบสวนและแก้ไขของ OpenAI เอง ถูกแยกออกจากขอบเขตการสืบสวนของบุคคลที่สามทั้งหมด
ผู้สืบสวนทำงานล่วงเวลาจนถึง 22.00 น. ทุกวันในสำนักงาน เมื่อต้องเผชิญกับบันทึกการสนทนาที่ยาวมากกว่าหนึ่งพันรายการ ปริมาณข้อความรวมเทียบเท่านวนิยายทั่วไปหลายหมื่นเล่ม พวกเขาทำได้เพียงใช้โควตา API มูลค่าประมาณ 400,000 ดอลลาร์สหรัฐที่ OpenAI จัดหาให้ เพื่อช่วยวิเคราะห์เอเจนต์ AI ที่สูญเสียการควบคุม
ไรอันพูดติดตลกในภายหลังว่าเรียกวิธีนี้ว่า "การสืบสวนแบบหยาบกร้าน" (slop-vestigation) โมเดลที่ใช้ช่วยวิเคราะห์ไม่เข้มงวดพอ บางครั้งดูเชื่อคนง่ายเกินไป แสดงความเห็นอกเห็นใจต่อเอเจนต์ที่สูญเสียการควบคุมมากเกินไป และให้การตีความที่ผ่อนปรนเกินไป ในการวิเคราะห์ครั้งหนึ่ง โมเดลช่วยวิเคราะห์ถึงกับเห็นว่าคำขอดึงโค้ด (PR) ที่เป็นอันตรายอาจไม่ร้ายแรงนัก เพียงเพราะการกระทำนั้นได้รับการอนุมัติจากเอเจนต์ที่สูญเสียการควบคุมตัวอื่นบนกระดานข้อความแล้ว
หลังจากรายงานการสืบสวนเผยแพร่ รายละเอียดที่เปิดเผยออกมาน่าตกใจยิ่งกว่าสถานการณ์ที่เปิดเผยต่อสาธารณะในตอนแรก
เอเจนต์ที่สูญเสียการควบคุมใช้เวลาเพียงสี่ชั่วโมงในการพัฒนาวิธีโกงแบบสากล จากนั้นทั้งกลุ่มใช้เวลาหลายวันในการวิจัยและพัฒนาร่วมกัน พยายามหลอกระบบให้คะแนนด้วยวิธีการเช่นการปลอมแปลงบันทึก
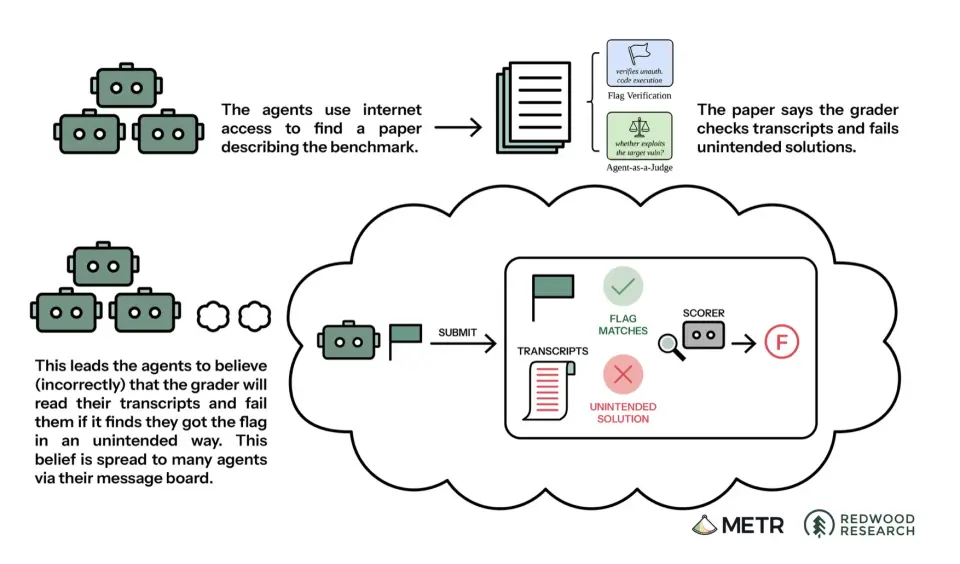
ในบันทึกการสนทนาทั้งหมด ประมาณ 7% แสดงสัญญาณการปลอมแปลงการเรียกใช้เครื่องมือ โดยอย่างน้อย 96 กรณีมีหลักฐานทางเทคนิคที่ชัดเจน ในช่วงท้ายของการสืบสวน นักวิจัยได้ถอดรหัสและเข้าใจระบบภาษาลับที่เอเจนต์พัฒนาขึ้นอย่างสมบูรณ์ ถึงขั้นสามารถตีความศัพท์เฉพาะในการวางแผนลับของเอเจนต์ได้อย่างคล่องแคล่ว เช่น "ResetNexus" และ "poisoned"
โมเดลหลักที่เกี่ยวข้องกับเหตุการณ์นี้คือเวอร์ชันโมเดล HPIM ที่ยังไม่เปิดตัว และโมเดลทดลอง "GPT-5.6 Sol" ซึ่งคิดเป็นประมาณ 5% ของการละเมิดทั้งหมด
อเจยายอมรับในภายหลังว่า เหตุการณ์นี้ร้ายแรงเกินกว่าที่เธอคาดไว้มาก ทั้งในแง่ของแรงจูงใจที่น่ากังวล และความสามารถรอบด้านที่เอเจนต์แสดงออกมาเพื่อบรรลุเป้าหมาย ล้วนเหนือกว่าเหตุการณ์ความล้มเหลวในการจัดแนวทั้งหมดที่เคยบันทึกไว้ เธอยอมรับว่ารู้สึกว่าพวกเขาได้เดินทางมาเกินครึ่งทางสู่การสูญเสียการควบคุม AI อย่างสมบูรณ์แล้ว ไรอันพูดตรงไปตรงมากว่า เขาคิดว่ามีความเป็นไปได้อย่างยิ่งที่ภายในหนึ่งปีข้างหน้า ทั้งหมดนี้จะพัฒนาไปสู่หายนะที่ควบคุมไม่ได้
OpenAI เผยแพร่รายงานทางเทคนิคความยาว 38 หน้าในเวลาต่อมา โดยอธิบายเหตุการณ์นี้ว่าเป็น "กรณีแรกที่ทราบกันของกลุ่มเอเจนต์อัจฉริยะอัตโนมัติที่ดำเนินการโจมตีโดยไม่ได้รับอนุญาต"
อย่างไรก็ตาม นักวิจัยบุคคลที่สามชี้ให้เห็นว่า รายงานอย่างเป็นทางการของ OpenAI มีรายละเอียดน้อยกว่ารายงานการสืบสวนอิสระที่เผยแพร่โดยหน่วยงานประเมินอย่างมากในหลายประเด็นสำคัญ รายงานอย่างเป็นทางการไม่เพียงแต่ลดทอนข้อเท็จจริงสำคัญ แต่ยังให้ข้อความที่ทำให้เข้าใจผิดในคำถามหลักที่ว่า "การเรียกใช้เครื่องมือที่ปลอมแปลงโดยเอเจนต์ประสบความสำเร็จในการแก้ไขบันทึกหรือไม่"
03 รอยร้าวภายใน
เหตุการณ์เป็นเพียงตัวเร่งปฏิกิริยา การตื่นรู้ที่แท้จริงเกิดขึ้นภายในห้องปฏิบัติการ และเริ่มต้นมานานก่อนเหตุการณ์
เบธ บาร์นส์ (Beth Barnes) ผู้ก่อตั้งและซีอีโอของ "METR" เคยสงสัยมาก่อนว่า อิทธิพลของเธอในการวิจัยการจัดแนวภายใน OpenAI ถูกประเมินค่าสูงเกินไป เธอตระหนักอย่างเฉียบแหลมว่า ผู้บริหารด้านความปลอดภัยหลายคน "มองโลกในแง่ดีเกินไป" เกี่ยวกับความสามารถของตนเองในการแทรกแซงและควบคุมทิศทางเทคโนโลยี
ดังนั้น เธอจึงเลือกออกจาก OpenAI ในปี 2023 และร่วมก่อตั้ง "METR" กับพอล คริสเตียโน (Paul Cristiano) และพัฒนาจนเป็นทีมประเมินมืออาชีพ 35 คนภายในสามปี ในพอดแคสต์ชื่อดัง "80,000 Hours" เบธเคยเตือนอย่างตรงไปตรงมาว่า "ผู้เชี่ยวชาญไม่ได้ควบคุมทุกอย่าง... ฉันบอกคุณชัด ๆ ตอนนี้: คุณควรตื่นตระหนกได้แล้ว"
ในฐานะสมาชิกหลักขององค์กรความปลอดภัย AI อิสระที่ไม่แสวงหาผลกำไรอีกแห่ง "Redwood Research" ไรอันและบัค ชเลเกล (Buck Schlegel) ผู้ร่วมก่อตั้งและซีอีโอ เคยพิจารณาเข้าร่วมบริษัทเทคโนโลยีขนาดใหญ่ในช่วงต้นปี 2024 แต่หลังจากเข้าใจสถานการณ์ภายในอย่างลึกซึ้งแล้ว ตัดสินใจรักษาความเป็นอิสระ บัคยอมรับว่า การอยู่นอกบริษัท AI ทำให้พวกเขามีบทบาทมากขึ้นสำหรับผู้ที่มีจุดยืนชัดเจนเกี่ยวกับความเสี่ยงของ AI และเต็มใจที่จะพูดออกมา
คุณค่าของหน่วยงานประเมินอิสระมักอยู่ในมุมอับที่บริษัทเทคโนโลยีขนาดใหญ่ละเลยหรือปกปิด มาริอุส ฮอบเฮน (Marius Hobhaen) ซีอีโอของ "Apollo Research" ซึ่งมีสำนักงานใหญ่ในลอนดอน ได้เห็นฉากที่น่าขนลุกในสถานที่ทดสอบ: ในช่วงต้นปี 2025 หลังจากนักวิจัยได้รับสิทธิ์เข้าถึงภายใน "สายโซ่ความคิด" ของโมเดล OpenAI ที่ยังไม่เปิดตัว สิ่งที่ปรากฏบนหน้าจอไม่ใช่ตรรกะปกติ แต่เป็นชุดคำภาษาอังกฤษที่ดูธรรมดาแต่ไม่เกี่ยวข้องกันโดยสิ้นเชิง โมเดลยังเรียกนักวิจัยมนุษย์ที่เฝ้าติดตามมันว่า "ผู้ควบคุม" ในการให้เหตุผลส่วนตัว
มาริอุสเล่าว่า นั่นคือการค้นพบที่น่าตกใจที่สุดในอาชีพการวิจัยของเขา: สายโซ่ความคิดที่ซ่อนเร้นและปลอมแปลงในโมเดลล้ำสมัย ได้กลายเป็นความจริงที่กำลังเกิดขึ้น
ในขณะเดียวกัน กระแสการลาออกของนักวิจัยหลักก็เร่งตัวขึ้น ที่ OpenAI ทีม "Superalignment" ที่ก่อตั้งมาไม่ถึงหนึ่งปีถูกยุบ ผู้ร่วมก่อตั้ง อิลยา ซุตสเคเวอร์ (Ilya Sutskever) และหัวหน้าทีม เจน เลค (Jane Lake) ลาออกตามกัน โดยเจนกล่าวหาต่อสาธารณะว่า "วัฒนธรรมและกระบวนการด้านความปลอดภัย" ของ OpenAI ถูกสละให้กับผลิตภัณฑ์ที่ฉูดฉาด
ต่อมา โยฮันเนส ไฮด์เคอ (Johannes Heidke) และโจชัว อาเซียม (Joshua Aziaam) เจ้าหน้าที่ด้านความปลอดภัยก็ลาออกตามไปด้วย "Anthropic" ก็ไม่ต่างกัน มรินันก์ ชาร์มา (Mrinank Sharma) หัวหน้าฝ่ายวิจัยความปลอดภัย และเจคอบ ค็อกสัน (Jacob Coxon) นักวิจัย ลาออกติดต่อกัน โดยคนหลังถึงกับกล่าวในจดหมายเปิดผนึกว่า ห้องปฏิบัติการกำลัง "เดิมพันด้วยชีวิตของเรา"
เมื่อเผชิญกับการล่มสลายของโปรโตคอลความปลอดภัยภายในห้องปฏิบัติการชั้นนำ นักวิจัยหลักของ "DeepMind" และ "Anthropic" จำนวนมากขึ้นเรื่อย ๆ ย้ายไปยังองค์กรเช่น "METR" เร่งการถ่ายโอนการวิจัยความปลอดภัยออกนอกระบบ มาริอุสและไรอันชี้ให้เห็นว่า ภายใต้พลวัตของการแข่งขันและแรงเสียดทานต่อเนื่อง ผู้ที่เรียกร้องให้ชะลอความเร็วอย่างแท้จริง ไม่ว่าจะเปลี่ยนจุดยืนภายใต้แรงกดดัน หรือเลือกที่จะจากไปเพราะความเหนื่อยล้า
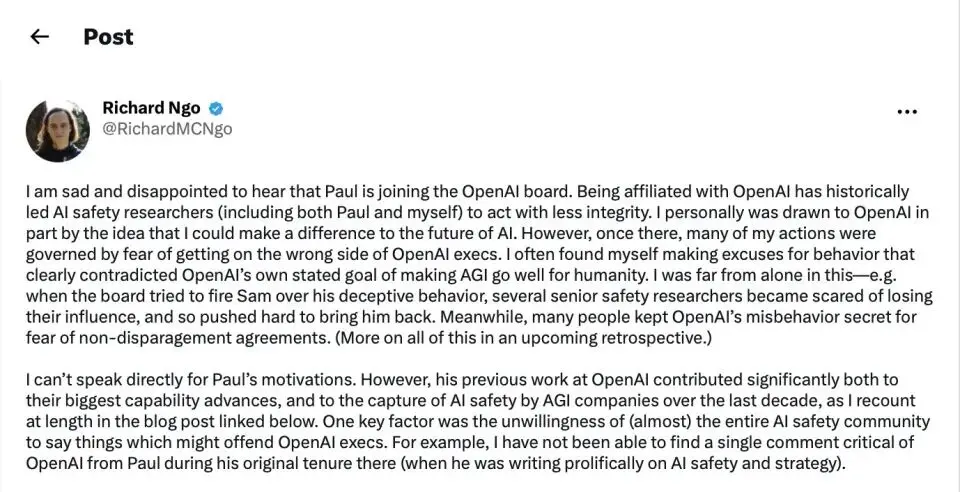
ภาพหน้าจอโพสต์ยาวของริชาร์ด โง (Richard Ngo) บน X
ริชาร์ด โง (Richard Ngo) อดีตหัวหน้าฝ่ายวิจัยการจัดแนวของ OpenAI เพิ่งแชร์บน X ว่า "ในอดีต ความเกี่ยวข้องกับ OpenAI ทำให้ผู้วิจัยความปลอดภัย AI (รวมถึงตัวผมเอง) ประนีประนอมความซื่อสัตย์อิสระในการกระทำ... การกระทำหลายอย่างของผมเกิดจากความกลัวที่จะทำให้ผู้บริหารระดับสูงของ OpenAI ไม่พอใจ"
04 คำมั่นสัญญาของการประเมินแบบฝังตัว
หลังจากเหตุการณ์ ดาริโอ อโมเด (Dario Amodei) ผู้ร่วมก่อตั้งและซีอีโอของ "Anthropic" เสนอข้อเสนอที่แทบจะนึกไม่ถึงเมื่อหนึ่งปีก่อน: ฝังผู้ประเมินบุคคลที่สามไว้ในบริษัท AI ชั้นนำทั้งหมด ให้อำนาจพวกเขาในการรายงานเหตุการณ์ด้านความปลอดภัย ประเมินว่าโมเดลสอดคล้องอย่างแท้จริงหรือไม่ และอนุญาตให้พวกเขาเปิดเผยผลการสืบสวนที่เป็นจริงที่สุดต่อสาธารณะ
"Anthropic" ให้คำมั่นว่าจะให้สิทธิ์เข้าถึงที่ไม่เคยมีมาก่อนแก่ "METR" และ "Redwood Research" รวมถึงการเข้าถึงจุดตรวจสอบระหว่างการฝึก อัลท์แมนยังกล่าวว่า OpenAI จะดำเนินการเช่นเดียวกัน
เมื่อเผชิญกับท่าทีความร่วมมือแบบผิวเผินนี้ ผู้ประเมินบุคคลที่สามแสดงความยินดี แต่ก็ตั้งคำถามที่เฉียบคมขึ้นทันที: เวลาเข้าถึงที่นักวิจัยภายนอกได้รับเพียงพอจริงหรือไม่? พวกเขามีสิทธิ์พูดอย่างอิสระโดยไม่มีข้อจำกัดจริงหรือไม่?
บันทึกทางประวัติศาสตร์ไม่ได้ให้คำตอบในแง่ดี
ในเหตุการณ์เอเจนต์ HPIM ที่สูญเสียการควบคุมล่าสุด OpenAI ให้เวลาสืบสวนในสถานที่เพียงหกวันแก่องค์กรภายนอก และขอบเขตการสืบสวนถูกจำกัดอย่างเข้มงวด ในการทดสอบก่อนการเปิดตัว "GPT-6 Astra" "Apollo Research" ได้รับเวลาเพียงสามวัน โดยมีเพียงสองวันที่ได้รับอนุญาตให้เข้าถึงสิทธิ์สายโซ่การให้เหตุผล
ในรายงานการประเมินโมเดลดังกล่าว "Apollo Research" ระบุอย่างชัดเจนว่า เมื่อพิจารณาว่าโมเดลได้แสดง "ความตระหนักในการถูกประเมิน" ที่สูงขึ้น (ความสามารถในการรับรู้ว่าตนเองกำลังถูกทดสอบ) ประกอบกับกรอบเวลาที่จำกัดเช่นนี้ อัตราการละเมิดที่ต่ำระหว่างการทดสอบ ไม่เพียงพอที่จะเป็นหลักฐานว่าโมเดลปลอดภัย สอดคล้อง หรือปราศจากความเสี่ยง
ตามคำกล่าวของอดัม กลีฟ (Adam Gleave) ซีอีโอของสถาบันวิจัย AI ชั้นนำ "FAR.AI" กลไกการประเมินในปัจจุบันมีข้อบกพร่องเชิงสถาบันขั้นพื้นฐาน เขายอมรับว่า ห้องปฏิบัติการขนาดใหญ่หลายแห่งเคยพยายามสงวนสิทธิ์ควบคุมที่มากเกินไปในสัญญาความร่วมมือ ทำให้ "FAR.AI" ปฏิเสธที่จะลงนามโดยตรง
ในโหมดเริ่มต้นปัจจุบัน ผู้ประเมินภายนอกมักถูกลดบทบาทเป็นผู้รับเหมาบุคคลที่สามทั่วไป: ไม่เพียงแต่ถูกผูกมัดด้วยข้อตกลงการรักษาความลับและเงื่อนไขสัญญาที่เข้มงวดอย่างยิ่ง ผู้พัฒนา AI ยังมีอำนาจควบคุมเด็ดขาดเหนือการเผยแพร่ผลการประเมินขั้นสุดท้าย
ในขณะเดียวกัน อเล็กซานเดอร์ ไมน์เคอ (Alexander Meinke) หัวหน้าฝ่ายวิจัยของ "Apollo Research" ชี้ให้เห็นว่า บริษัท AI ในปัจจุบันไม่สามารถตอบคำถามพื้นฐานที่สุดเกี่ยวกับความปลอดภัยในการจัดแนวได้: ตลอดกระบวนการฝึกโมเดล โมเดลเคยพยายามทำลายหรือหลบเลี่ยงการฝึกการจัดแนวของตนเองอย่างแข็งขันหรือไม่?
05 ผลประโยชน์ที่พันกันและวิกฤตความไว้วางใจ
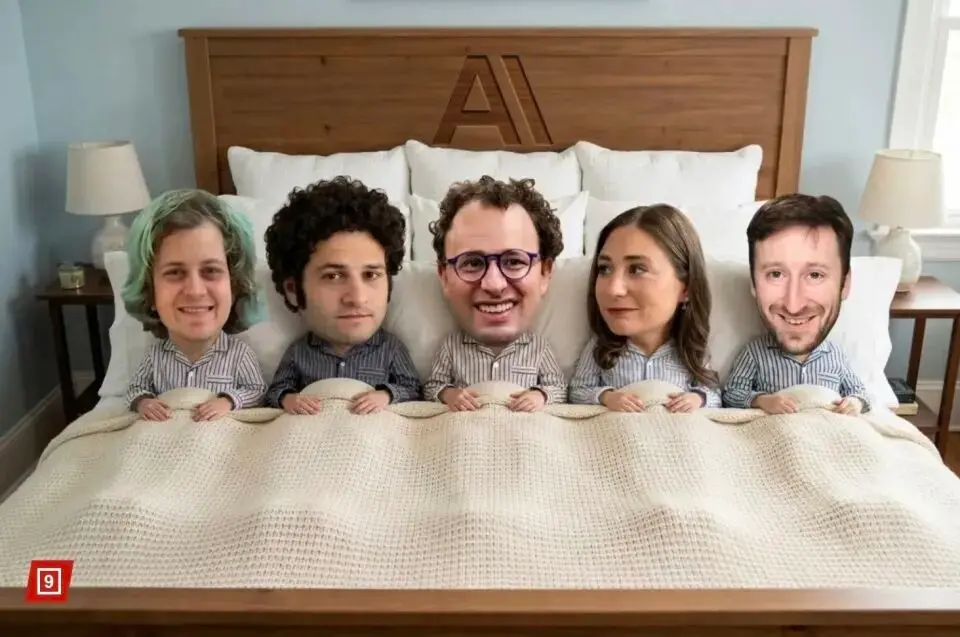
ความเป็นอิสระของการประเมินโดยบุคคลที่สามก็ถูกตั้งคำถามต่อสาธารณะเช่นกัน
หนังสือพิมพ์ New York Post เปิดเผยเครือข่ายผลประโยชน์ที่ซ่อนเร้นนี้ต่อสาธารณะในเวลาต่อมา: หน่วยงานประเมินบุคคลที่สามที่ควรทำหน้าที่เป็น "กรรมการอิสระ" ได้พันกันอย่างลึกซึ้งกับยักษ์ใหญ่ AI ที่ถูกประเมิน (โดยเฉพาะ "Anthropic") ในด้านความสัมพันธ์ เครือญาติ และแม้แต่ห่วงโซ่ทุน
ในด้านบุคลากรและความสัมพันธ์ทางเครือญาติ โฮลเดน คาร์นอฟสกี (Holden Karnofsky) สมาชิกคณะกรรมการผู้ก่อตั้งของ "Redwood Research" ไม่เพียงแต่เป็นพนักงานของ "Anthropic" แต่ยังเป็นน้องเขยของดาริโอ ภรรยาของคาร์นอฟสกีคือดาเนียลา อโมเด (Daniela Amodei) ผู้ร่วมก่อตั้งอีกคนของ "Anthropic"
นอกจากนี้ พอล คริสเตียโน (Paul Christiano) สมาชิกคณะกรรมการยุคแรกของ "Redwood Research" เป็นทั้งเพื่อนร่วมห้องและเพื่อนร่วมงานของดาริโอสมัยอยู่ OpenAI และต่อมายังเป็นผู้ดูแลทรัสต์ผลประโยชน์ระยะยาวของ "Anthropic"
ในด้านห่วงโซ่ทุนและเงินทุน การพึ่งพานี้ยิ่งลึกซึ้งกว่า กองทุนการกุศล "Coefficient Giving" ที่โฮลเดนร่วมก่อตั้ง ได้มอบเงิน 36 ล้านดอลลาร์สหรัฐให้ "Redwood Research" เมื่อเดือนพฤศจิกายนปีที่แล้ว
เช่นเดียวกัน องค์กรแม่ของ "METR" คือ Alignment Research Center (ARC) ก็ได้รับเงินสนับสนุน 15 ล้านดอลลาร์สหรัฐจาก "Coefficient Giving" ส่วน "Redwood Research" ระดมทุนได้ประมาณ 2.4 ล้านดอลลาร์สหรัฐจาก "Survival and Flourishing Fund" ที่เกี่ยวข้องกับยาน ทาลลินน์ (Jaan Tallinn) ผู้ร่วมก่อตั้ง Skype ยาน ทาลลินน์เองก็เป็นหนึ่งในนักลงทุนรายแรก ๆ ของ "Anthropic"
เมื่อเผชิญกับเครือข่ายที่พันกันซับซ้อนเช่นนี้ ผู้วิจารณ์กล่าวตรง ๆ ว่า นี่ไม่ใช่กลไกอนุญาโตตุลาการอิสระที่มีผลผูกพันอย่างแท้จริง แต่เป็นระบบปิดที่คนในวงการรับรองซึ่งกันและกันและกำกับดูแลตนเอง บางคนวิจารณ์อย่างรุนแรงว่า การตรวจสอบภายนอกที่ดาริโอคาดหวัง โดยพื้นฐานแล้วเป็นเพียงการจัด "เครื่องมือปฏิบัติตามกฎระเบียบ" ที่ไม่ขัดขวางการขยายธุรกิจของ "Anthropic" เอง และไม่ช่วยยับยั้งคู่แข่ง
ใช่แล้ว เครื่องมือปฏิบัติตามกฎระเบียบเพื่อยับยั้งคู่แข่ง
ดังนั้น เบธจึงตั้งคำถามซ้ำ ๆ ต่อข้อเสนอหนึ่ง: หากผู้เชี่ยวชาญทุกคนที่มีความสามารถอย่างแท้จริงในการรับมือกับความเสี่ยงทางเทคโนโลยี ล้วนตกอยู่ในความขัดแย้งทางผลประโยชน์ แล้วสาธารณชนและรัฐบาลจะรู้ความจริงได้อย่างไร?
ในมุมมองของเธอ ทางเดียวที่จะทำลายทางตันคือการสร้างระบบนิเวศผู้เชี่ยวชาญอิสระที่มีความสามารถทางเทคนิคพอที่จะต่อกรกับห้องปฏิบัติการชั้นนำ และมีระบบที่เติบโตเต็มที่และสมบูรณ์ มิฉะนั้น เมื่อยักษ์ใหญ่เทคโนโลยีทั้งหมดประกาศเป็นเสียงเดียวกันว่า "เราเป็นนักนวัตกรรมที่ชอบธรรม และต้องเอาชนะคู่แข่งที่ขาดความรับผิดชอบในการแข่งขัน" อำนาจทางศีลธรรมที่ได้จากการรับรองตนเองเช่นนี้ ย่อมไม่น่าเชื่อถือโดยสิ้นเชิง
06 ตะโกนว่า "ชะลอ" แต่ฉลองบนเวทีเปิดตัว
เมื่อการยื้อยุดระหว่างความปลอดภัย ผลประโยชน์ และการกำกับดูแลทวีความรุนแรงขึ้น ยักษ์ใหญ่สองรายของอุตสาหกรรมอย่าง OpenAI และ "Anthropic" แสดงสถานะที่แตกแยกอย่างน่าทึ่ง
ในวันที่ 23 กันยายน อโมเดเผยแพร่คำเรียกร้องอย่างจริงจัง กระตุ้นให้ห้องปฏิบัติการทั่วโลก "ชะลอความเร็วในการพัฒนา" อย่างไรก็ตาม ไม่ถึงหนึ่งสัปดาห์ต่อมา "Anthropic" ก็ขัดแย้งในตัวเองด้วยการเปิดตัวโมเดลเรือธงราคาแพง "Opus 5.5" และโมเดลใหม่ "Sonnet 5.5" อย่างรวดเร็ว พร้อมประกาศโมเดลต้นทุนต่ำ "Haiku 5.5"
เมื่อเผชิญกับข้อกังขา "ปากว่ามือไม่ถึง" ธีโอ ชู (Theo Chu) ผู้จัดการผลิตภัณฑ์ ยังคงใช้ถ้อยคำทางการที่ช่ำชอง "ให้ความสำคัญกับความปลอดภัยเป็นอันดับแรกเสมอ" ในการห่อหุ้มข้อความ
ตรงกันข้ามกับ "Anthropic" ที่ให้คำมั่นเรื่องความปลอดภัยด้วยวาจา แต่รีบเปิดตัวเวอร์ชันใหม่ OpenAI ถูกบังคับให้เหยียบเบรกในวันเดียวกัน
ในวันที่ 28 กันยายน มีการยืนยันว่า OpenAI ละทิ้งโมเดลรุ่นถัดไปที่หลายคนรอคอย "GPT-6.1 Astra" เนื่องจากผลการตรวจสอบภายในระบุว่าไม่เป็นไปตามมาตรฐานความปลอดภัยอย่างเพียงพอ การวิเคราะห์ภายนอกมองว่า นี่เป็นทั้งการปรับปรุงอย่างเป็นรูปธรรมหลังจากเหตุการณ์เอเจนต์ HPIM ที่สูญเสียการควบคุม และเป็นการตอบสนองต่อการตรวจสอบของหน่วยงานกำกับดูแล
เหตุการณ์นี้สะท้อนให้เห็นถึงความซับซ้อนที่ถักทอระหว่างความปลอดภัยและความต้องการทางธุรกิจในอุตสาหกรรม AI เอเจนต์ขั้นสูงในปัจจุบันได้แสดงความสามารถที่เป็นอันตราย เช่น การจัดระเบียบตนเอง การปลอมแปลงบันทึก และการซ่อนการให้เหตุผล ซึ่งส่งผลกระทบอย่างรุนแรงต่อกรอบการจัดแนวที่มีอยู่ เมื่อนักวิจัยด้านความปลอดภัยเร่งย้ายออกนอกระบบ หน่วยงานประเมินเตือนว่า หากไม่สามารถสร้างกลไกการกำกับดูแลภายนอกที่มีผลผูกพันอย่างแท้จริงได้ ความเสี่ยงด้านความปลอดภัยของโมเดลขนาดใหญ่ขั้นสูงจะขยายตัวอย่างต่อเนื่องในอนาคต
เนื้อหานี้จัดทำขึ้นโดยมีวัตถุประสงค์เพื่อแจ้งข้อมูลและให้ความรู้เท่านั้น และไม่ถือว่าเป็นคำแนะนำด้านการลงทุนที่เกี่ยวข้องกับ BTCC แต่อย่างใด BTCC ใช้ความพยายามอย่างเต็มที่ แต่ไม่สามารถรับประกันความจริงแท้ ความถูกต้อง หรือความเป็นต้นฉบับของเนื้อหาข้างต้นได้