GPT-6.2 เปิดตัวแล้ว: ทำ PPT ได้ สร้างโมเดลประเมินมูลค่า ทำโมเดล 3 มิติ แต่ยังมีภาพหลอนสูงถึง 59%
 chaincatcher
บทความ | เสี่ยวจิง
บรรณาธิการ | สวี ชิงหยาง
เมื่อวันที่ 17 พฤศจิกายน ตามเวลาท้องถิ่นสหรัฐอเมริกา OpenAI ได้เปิดตัว GPT-6.2 Astra และ GPT-6.2 Sol อย่างเป็นทางการ
การเปิดตัวครั้งนี้มาช้ากว่าที่คาดไว้ ตั้งแต่ปลายเดือนตุลาคม ผู้ใช้บางรายพบร่องรอยที่สงสัยว่าเป็น GPT-6.2 ในบันทึกการใช้งาน ChatGPT และหลังจากนั้นก็มีตัวระบุรุ่นและภาพหน้าจอการทดสอบหลุดออกมาอย่างต่อเนื่อง ก่อนหน้านี้สื่อคาดการณ์ว่ารุ่นใหม่จะเปิดตัวเร็วที่สุดในวันที่ 6 พฤศจิกายน แต่วันเปิดตัวจริงช้ากว่าที่คาดไว้ 11 วัน
OpenAI เน้นย้ำถึงความสามารถของ AI ในการรับช่วงงานระดับมืออาชีพในครั้งนี้
ตั้งแต่การจำลองงานนำเสนอทั้งหมดจากภาพหน้าจอ PPT ไปจนถึงการดึงข้อมูลทางการเงิน สร้างโมเดลประเมินมูลค่า ใช้งาน Blender เพื่อสร้างโมเดล 3 มิติของรถยนต์ จำลองการเคลื่อนไหวทางกายภาพของระบบกันสะเทือนรถยนต์ และแม้แต่ใช้ CAD ออกแบบชิ้นส่วนเครื่องกลและตรวจสอบความสัมพันธ์ในการประกอบ GPT-6.2 เริ่มเจาะลึกงานที่ก่อนหน้านี้ต้องอาศัยผู้เชี่ยวชาญใช้ซอฟต์แวร์ที่ซับซ้อน
OpenAI เน้นเป็นพิเศษว่ารุ่นใหม่สามารถลดผลลัพธ์ที่ไม่มีประสิทธิภาพและการแก้ไขซ้ำซ้อน ทำให้ผลลัพธ์ที่ AI ส่งมอบใกล้เคียงกับมาตรฐานงานระดับมืออาชีพมากขึ้น
ในช่วงสองเดือนที่ผ่านมา OpenAI ได้เปิดตัวรุ่นต่างๆ อย่างต่อเนื่อง เช่น GPT-6 Astra, Sol และ Luna รวมถึง GPT-6.1 Sol และ Terra GPT-6.2 Astra ที่เพิ่งเปิดตัวเป็นการอัปเกรดต่อจากรุ่นเรือธง GPT-6 Astra เมื่อเดือนกันยายน โดยเน้นการปรับปรุงการจัดการงานระดับมืออาชีพที่ซับซ้อน ส่วน GPT-6.2 Sol เน้นเสริมประสิทธิภาพงานประจำวัน การเขียนโปรแกรม และงานเอเจนต์หลายขั้นตอน
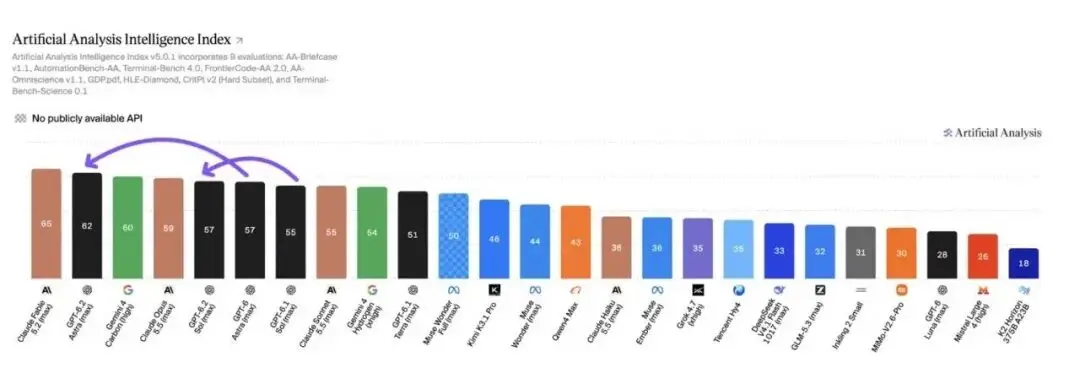
ตามรายการล่าสุดจาก Artificial Analysis Astra ขึ้นสู่อันดับสองของโลกด้วยคะแนน 62 เพิ่มขึ้น 5 คะแนนจากรุ่นก่อนหน้า ส่วน Sol ได้คะแนน 57 ในด้านราคา ราคาต่อหน่วยอินพุตและเอาต์พุตของ API ของ Astra ลดลง 20% และราคาอินพุตแบบแคชลดลง 60% ส่วน Sol คงราคาเดิม แต่ต้นทุนรวมในการทำงานบางอย่างลดลงอีก
ที่น่าสังเกตคือ GPT-6.2 Astra ยังเป็นรุ่นแรกของ OpenAI ที่ได้รับการประเมินสาธารณะว่าถึงเกณฑ์ความสามารถระดับ "สูง" สำหรับการปรับปรุงตนเองของ AI
อย่างไรก็ตาม การสาธิตและคะแนนที่น่าประทับใจก็ได้รับเสียงวิจารณ์ที่หลากหลาย ในวันเปิดตัว นักพัฒนาหลายรายที่ได้ทดสอบรุ่นใหม่ล่วงหน้าหลายสัปดาห์แสดงความผิดหวังต่อสาธารณะ โดยเชื่อว่า Astra อาจหยุดทำงานก่อนเวลาอันควรในงานพัฒนาซอฟต์แวร์ระยะยาว และผลลัพธ์ที่สั้นเกินไปบางครั้งก็ขาดข้อมูลที่จำเป็น
ในขณะเดียวกัน เมื่อความสามารถของรุ่นเข้าใกล้การทำงานระดับมืออาชีพจริง ขอบเขตความสามารถและการควบคุมความปลอดภัยก็กลายเป็นจุดเด่นสำคัญของการเปิดตัวครั้งนี้ด้วย
Sam Altman ซีอีโอของ OpenAI ภาพสร้างโดย AI
01 ประสิทธิภาพและต้นทุน
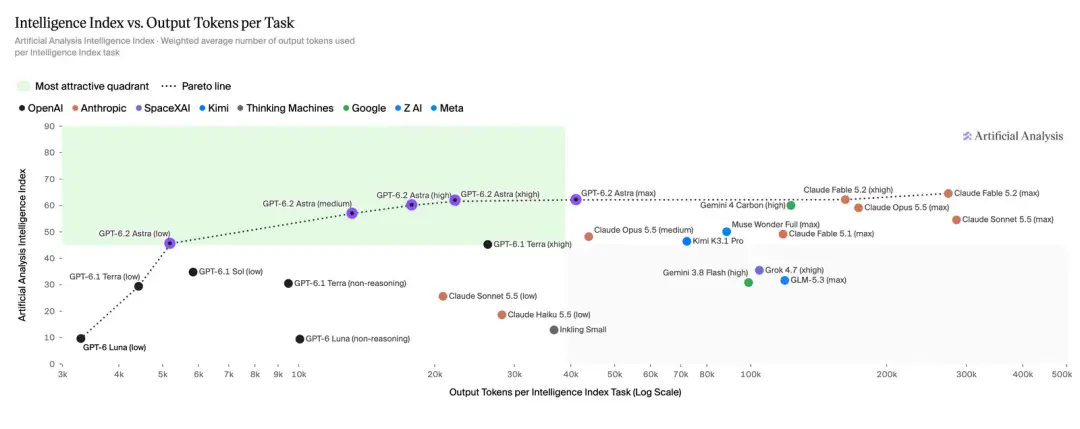
ราคา API ของ GPT-6.2 Astra อยู่ที่ 8 ดอลลาร์ต่อ 1 ล้านโทเคนอินพุต และ 40 ดอลลาร์ต่อ 1 ล้านโทเคนเอาต์พุต โดยอินพุตแบบแคชราคา 0.40 ดอลลาร์ เมื่อเทียบกับรุ่นก่อนหน้า ราคาอินพุตและเอาต์พุตลดลง 20% และอินพุตแบบแคชลดลงจาก 1 ดอลลาร์เหลือ 0.40 ดอลลาร์ หรือลดลง 60% GPT-6.2 Sol คงราคา 2 ดอลลาร์ต่อ 1 ล้านโทเคนอินพุต และ 10 ดอลลาร์ต่อ 1 ล้านโทเคนเอาต์พุต
สำหรับเอเจนต์หลายขั้นตอน ราคาต่อหน่วยของ API ไม่ได้สะท้อนค่าใช้จ่ายจริงทั้งหมด เมื่อรุ่นทำงาน อาจต้องเรียกใช้เครื่องมือหลายครั้ง อ่านไฟล์ จัดการข้อผิดพลาด และลองใหม่ แม้ราคาต่อหน่วยจะไม่เปลี่ยนแปลง แต่ถ้าใช้โทเคนน้อยลงในการทำงานให้เสร็จ บิลสุดท้ายก็จะลดลงตามไปด้วย
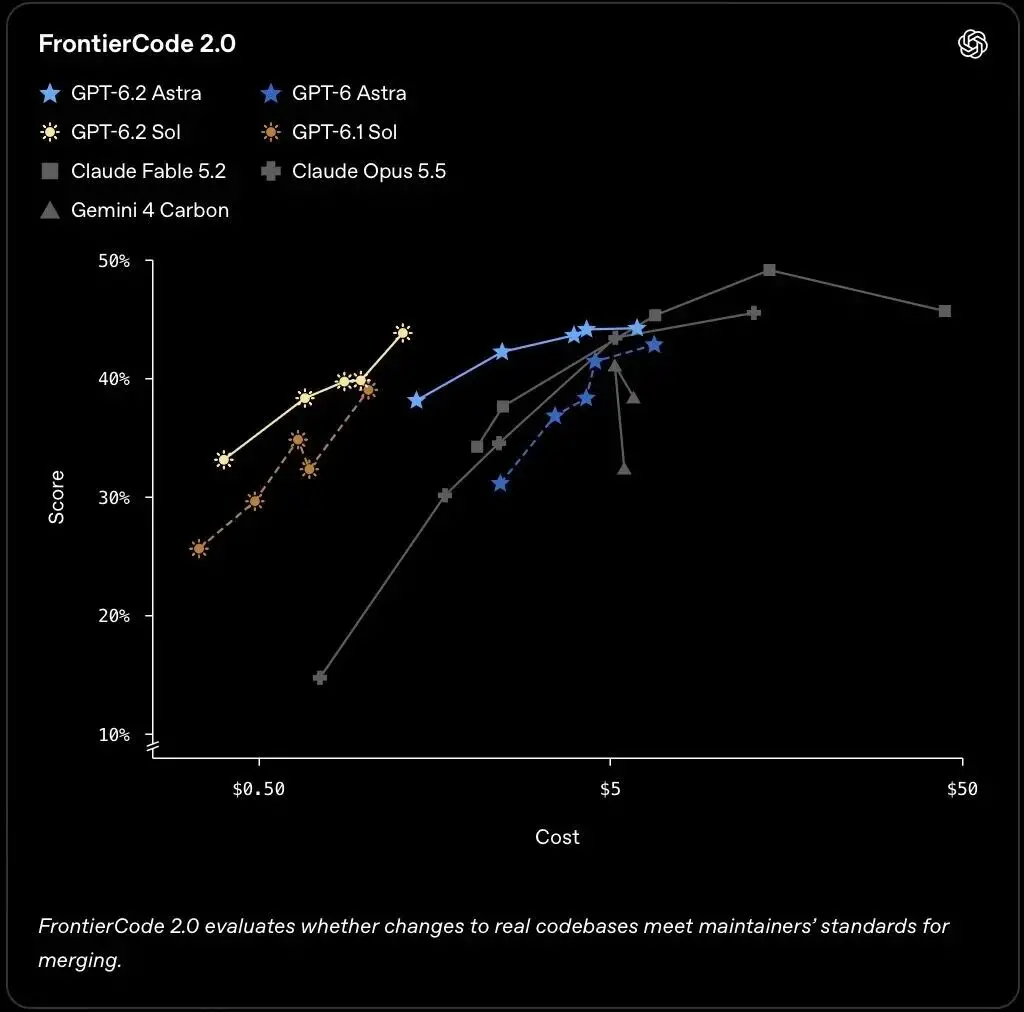
ในการทดสอบการเขียนโปรแกรม FrontierCode 2.0 โดย Cognition, GPT-6.2 Sol ได้คะแนนน้อยกว่า Astra เพียง 0.5 คะแนน แต่มีต้นทุนประมาณหนึ่งในห้าของรุ่นหลัง ในการประเมิน LifeVal ที่มุ่งเป้างานซับซ้อนในชีวิตประจำวัน คะแนนของ Sol แซงหน้ารุ่นเรือธงก่อนหน้าอย่าง GPT-6 Astra โดยต้นทุนต่องานอยู่ที่ประมาณหนึ่งในเจ็ดของรุ่นหลัง
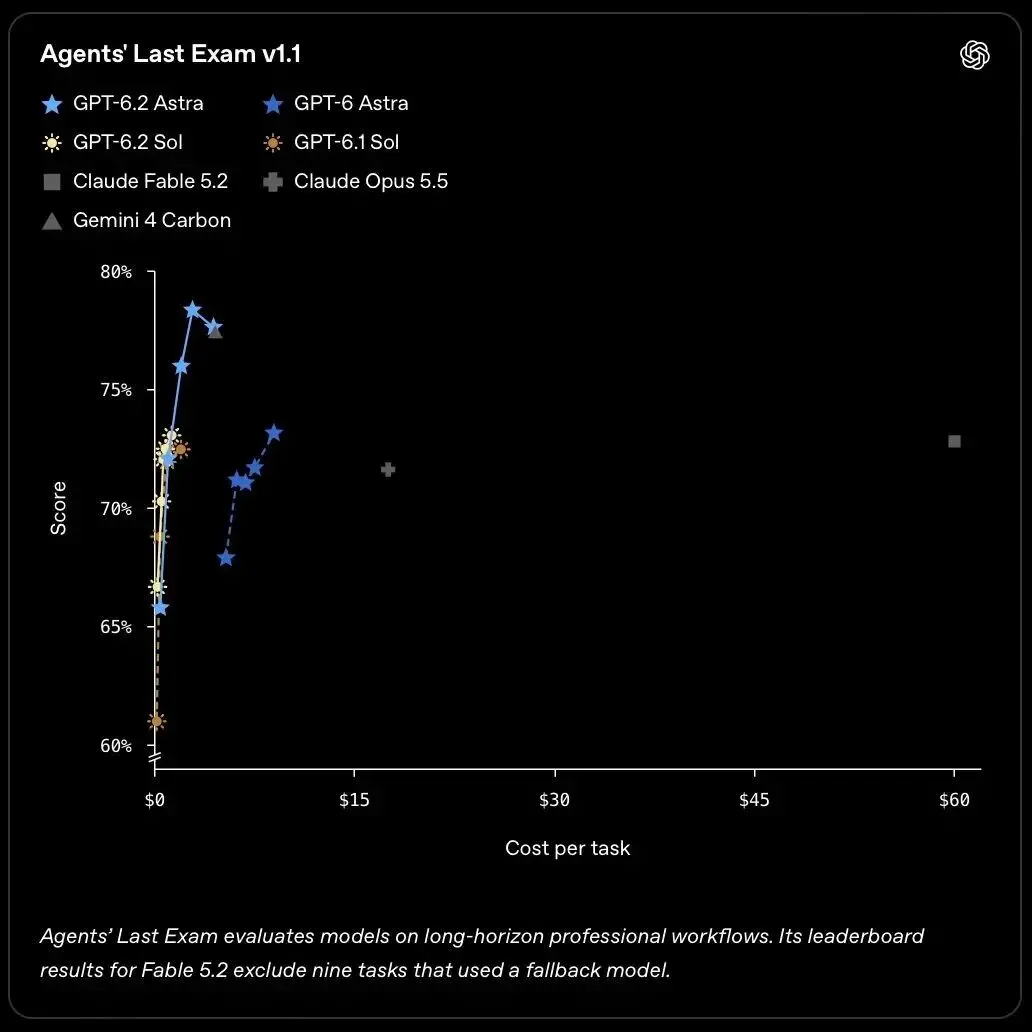
Astra ยังแสดงการปรับปรุงในงานที่ยากขึ้น ในการประเมิน Agents' Last Exam คะแนนดีขึ้น 5.2 คะแนนเมื่อเทียบกับ GPT-6 Astra โดยต้นทุนในการทำงานให้เสร็จน้อยกว่าหนึ่งในสามของรุ่นก่อนหน้า เมื่อเทียบกับ Claude Fable 5.2 Astra ได้คะแนนสูงกว่า 5.5 คะแนน โดยต้นทุนต่องานอยู่ที่ประมาณ 5% ของรุ่นหลัง
02 การส่งมอบงานระดับมืออาชีพ
งานระดับมืออาชีพในด้านการเงิน กฎหมาย และงานที่ปรึกษา ต้องการให้ AI จัดการข้อมูลดิบจำนวนมาก ตรวจสอบข้อมูล และผลิตผลงานตามมาตรฐานอุตสาหกรรม OpenAI ระบุว่า GPT-6.2 Astra ปรับปรุงงานเหล่านี้ได้ดีขึ้น สามารถทำโมเดลการเงิน วิเคราะห์การควบรวมกิจการ วิจัยกฎหมาย และวิเคราะห์วิทยาศาสตร์ข้อมูล
การทดสอบภายใน GDPval v2 ของ OpenAI ครอบคลุมสาขาต่างๆ เช่น งานที่ปรึกษา การเงิน และการออกแบบ โดยคะแนนของ Astra ดีขึ้น 6.2 เปอร์เซ็นต์พอยต์เมื่อเทียบกับรุ่นก่อนหน้า และโทเคนเอาต์พุตลดลง 22%
ในการวิจัยกฎหมาย ในการทดสอบ Harvey LAB-AA v1.1 ที่จำลองงานสำนักงานกฎหมายจริง อัตราการผ่านของ Astra สูงกว่า Claude Fable 5.2 มากกว่าสองเท่า โดยต้นทุนต่องานอยู่ที่ประมาณหนึ่งในหกของรุ่นหลัง
การทดสอบภายใน GDPval v2 ของ OpenAI ยังครอบคลุมงานที่ปรึกษา การเงิน และการออกแบบ ผลการทดสอบแสดงให้เห็นว่าคะแนนของ Astra ดีขึ้น 6.2 เปอร์เซ็นต์พอยต์เมื่อเทียบกับรุ่นก่อนหน้า โดยโทเคนเอาต์พุตลดลง 22%
03 ก้าวเข้าสู่โลก 3 มิติ
ความสามารถอีกอย่างที่ GPT-6.2 Astra แสดงให้เห็นคือการทำงานโดยตรงในการสร้างโมเดล 3 มิติและการออกแบบทางวิศวกรรม รุ่นนี้ไม่เพียงแค่สร้างโค้ดโมเดลอีกต่อไป แต่ยังสามารถใช้งานซอฟต์แวร์ระดับมืออาชีพ จัดการชิ้นส่วน ปรับโครงสร้าง และสร้างเนื้อหาภาพจากผลการคำนวณ
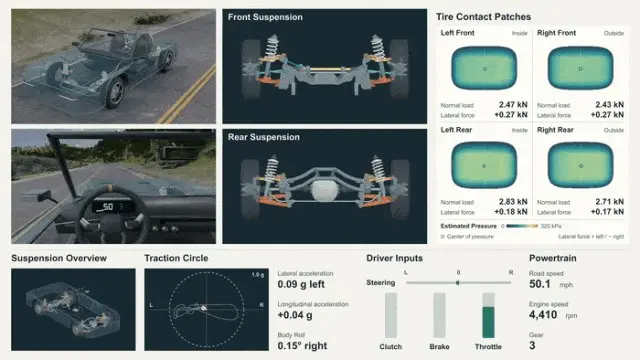
GPT-6.2 Astra จำลองการขับขี่บนถนนภูเขาและพลศาสตร์ของแชสซี
ในกรณีจำลองการขับขี่บนถนนภูเขา Astra สร้างโมเดล 3 มิติของรถสปอร์ตก่อน จากนั้นเขียนตัวแก้สมการฟิสิกส์ด้วย Python เพื่อคำนวณแรงยึดเกาะของยางและการเปลี่ยนแปลงพลศาสตร์ของระบบกันสะเทือน และสุดท้ายนำผลการคำนวณเข้า Blender เพื่อสร้างแอนิเมชันการขับขี่ของรถ ผ่านการจำลอง วิศวกรสามารถสังเกตสถานการณ์การถ่ายโอนน้ำหนักเมื่อรถวิ่งผ่านสภาพถนนที่ซับซ้อนก่อนสร้างต้นแบบจริง
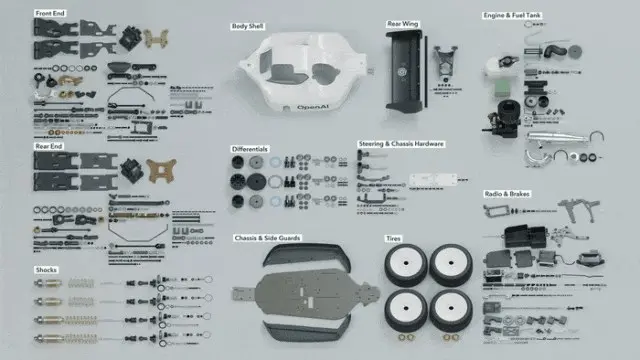
ข้อมูลอินพุตสำหรับกรณีแบบจำลองทางกลนั้นง่ายกว่ามาก OpenAI เพียงให้ภาพถ่ายสาธารณะและคู่มือการประกอบของรถออฟโรดบังคับวิทยุขนาด 1:8 และเครื่องยนต์หกสูบเรียง จากข้อมูลนี้ Astra สร้างโมเดล 3 มิติของชิ้นส่วนเครื่องกลต่างๆ และสร้างแอนิเมชันการประกอบทีละขั้นตอนพร้อมแคตตาล็อกชิ้นส่วนที่มีภาพประกอบ
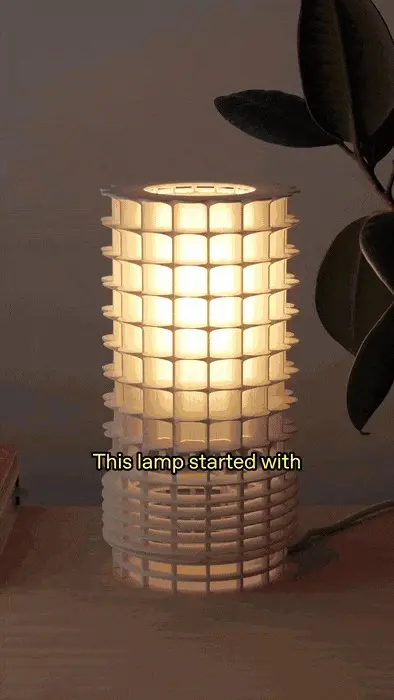
การทดสอบอีกหนึ่งรายการยังเชื่อมโยงการออกแบบ CAD กับการผลิตจริง ทีม OpenAI ให้ภาพถ่ายระเบียงรูปพัดของอาคาร Marina City แลนด์มาร์กในชิคาโกเพื่อให้รุ่นใช้อ้างอิงในการออกแบบ หลังจากการปรับหลายครั้ง Astra สร้างโคมไฟตั้งโต๊ะศิลปะกระดาษที่สามารถพิมพ์และประกอบได้ และเขียนหน้าเว็บสนับสนุนชื่อ Lamp Builder เพื่อให้ผู้ใช้ปรับพารามิเตอร์ออนไลน์และสร้างแบบวาดที่กำหนดเอง
GPT-6.2 Astra สร้างโมเดลเครื่องกลของรถออฟโรดบังคับวิทยุและเครื่องยนต์เสร็จสมบูรณ์
ในการพัฒนาเว็บ Astra สร้างเครื่องมือกำหนดค่าแบบโต้ตอบสำหรับรถบ้านแคมป์ปิ้ง ผู้ใช้สามารถเปลี่ยนสีตัวถังและเพิ่มเต็นท์หลังคา โดยราคาในหน้าอัปเดตแบบเรียลไทม์ นอกจากนี้ยังสร้างโต๊ะพินบอลที่เล่นได้ โมเดลโคลอสเซียมโรมัน และเกมแข่งรถเมืองอนาคตชื่อ "Meridian Sound Racing" จากคำอธิบายข้อความ
จากอาคาร Marina City ในชิคาโกสู่โคมไฟตั้งโต๊ะศิลปะกระดาษ
การทดสอบแบบ blind test โดยมนุษย์ AA-3D ของ Artificial Analysis ยังเปรียบเทียบความสามารถในการสร้าง 3 มิติของรุ่นต่างๆ GPT-6.2 Astra ได้คะแนน Elo 1318 อยู่ในอันดับหนึ่ง Claude Fable 5.2 ได้ 1271 คะแนน และ GPT-6.2 Sol ได้ 1259 คะแนน
เครื่องมือกำหนดค่าแบบโต้ตอบสำหรับรถบ้านแคมป์ปิ้งที่สร้างโดย GPT-6.2 Astra
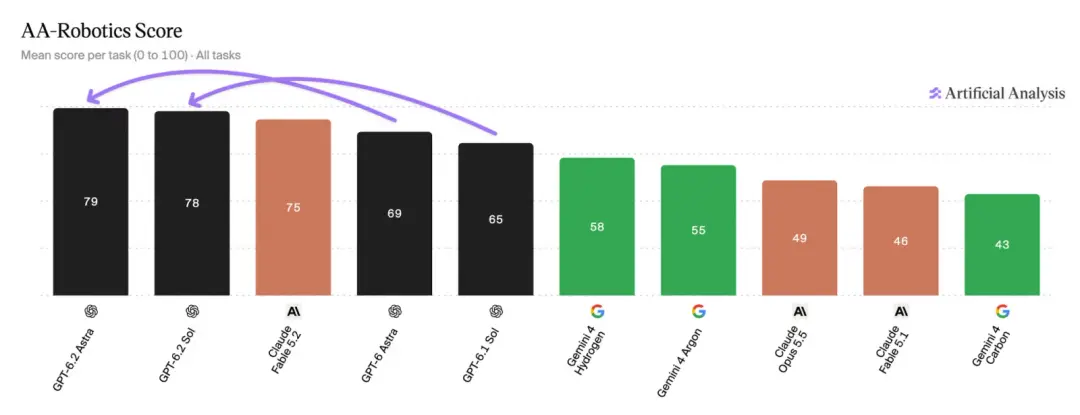
ในการทดสอบเบื้องต้น AA-Robotics v0.1 ที่ทดสอบความเข้าใจโลกกายภาพและความสามารถในการวางแผนการกระทำ Astra และ Sol ได้คะแนน 79 และ 78 ตามลำดับ สูงกว่า Claude Fable 5.2 ที่ได้ 75 คะแนน อย่างไรก็ตาม ทีมประเมินระบุว่ารุ่นชั้นนำในปัจจุบันสามารถทำงานพื้นฐานส่วนใหญ่ในการทดสอบเบื้องต้นได้แล้ว และกำลังเพิ่มความยากของคำถาม
04 การให้เหตุผลทางวิทยาศาสตร์และข้อบกพร่อง
การวิจัยทางวิทยาศาสตร์ก็เป็นจุดเน้นสำคัญของการสาธิตของ OpenAI ในครั้งนี้
ในการทดสอบ Terminal-Bench-Science 0.1 GPT-6.2 Astra ดีขึ้น 9 จุดเปอร์เซ็นต์เมื่อเทียบกับรุ่นก่อนหน้า อยู่ในอันดับหนึ่ง การทดสอบนี้ประเมินความสามารถของรุ่นในการทำงานทางวิทยาศาสตร์ในสภาพแวดล้อมเทอร์มินัลเป็นหลัก ใน Vals Science Index ซึ่งต้องการให้รุ่นตีความข้อมูลชีวภาพจริง ออกแบบการทดลอง และอนุมานกลไกของระบบ Astra ก็ทำสถิติใหม่สูงสุด
ผลการทดสอบอื่นๆ หลายรายการด้อยกว่า Claude Fable 5.2 เล็กน้อย ในชุดย่อยความยากสูงของเกณฑ์การให้เหตุผลทางฟิสิกส์ CritPt v2 การประเมินความรู้ข้อเท็จจริง AA-Omniscience v1.1 และเกณฑ์การให้เหตุผล HLE-Diamond Astra อยู่ในอันดับสอง
ปัญหาหนึ่งที่ยังคงมีอยู่กับรุ่นนี้คืออาจให้คำตอบที่ไม่ถูกต้องเมื่อเผชิญกับข้อเท็จจริงที่ไม่แน่นอน
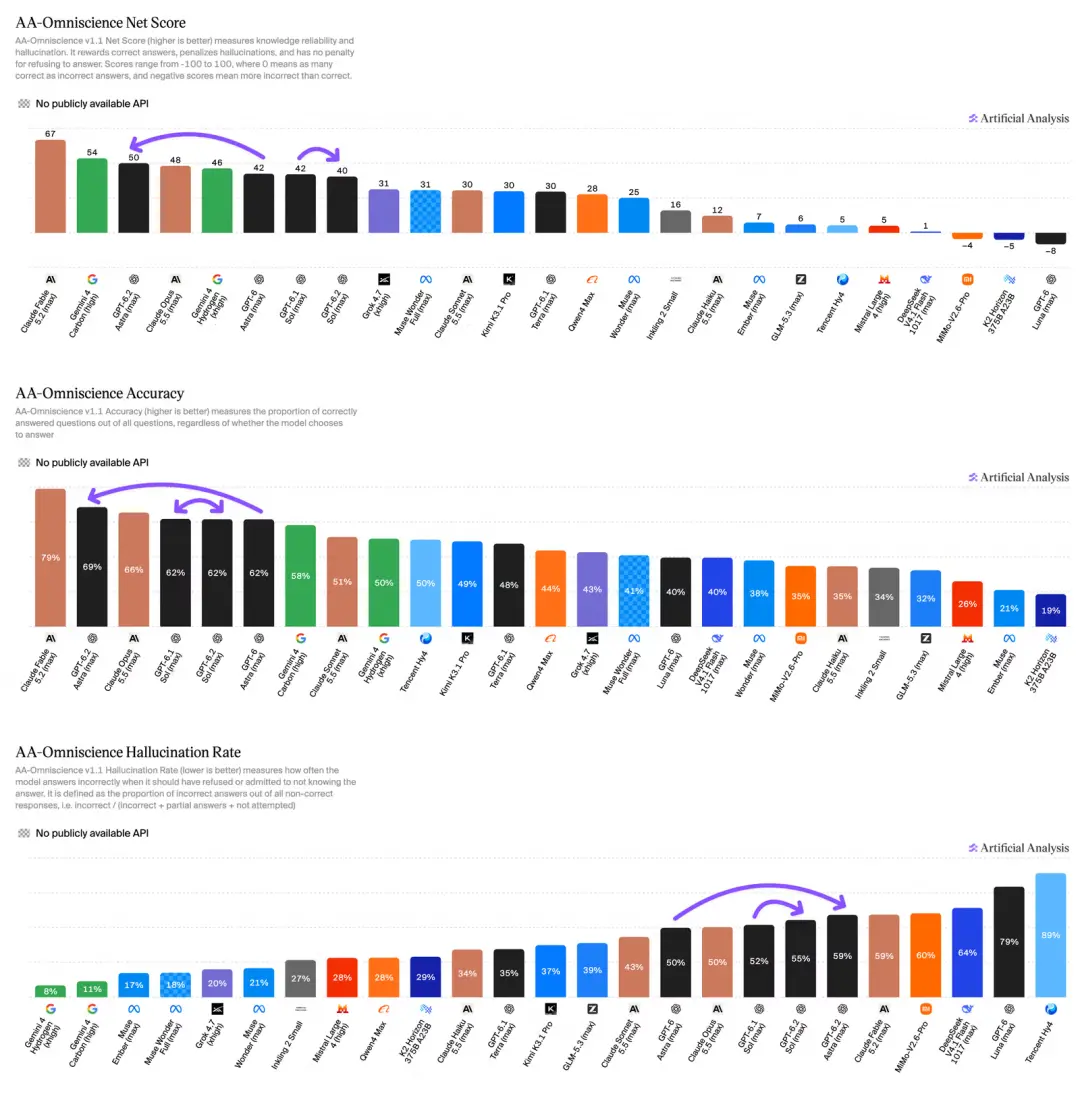
การทดสอบอัตราการเกิดภาพหลอนของ AA-Omniscience ของ Artificial Analysis แสดงให้เห็นว่าที่ระดับความเข้มข้นของการให้เหตุผลสูงสุด อัตราการเกิดภาพหลอนของ GPT-6.2 Astra และ Sol อยู่ที่ 59% และ 55% ตามลำดับ การทดสอบนี้ตรวจสอบว่ารุ่นมีแนวโน้มที่จะเดาคำตอบเมื่อเผชิญกับคำถามข้อเท็จจริงที่อาจไม่มีคำตอบหรือไม่ ไม่ได้แสดงถึงอัตราข้อผิดพลาดของรุ่นในการถามตอบทั่วไป แต่สำหรับสถานการณ์เช่นการตรวจสอบบัญชีการเงินและการอ้างอิงกฎหมาย ยังจำเป็นต้องมีการตรวจสอบโดยมนุษย์
การทดสอบการเขียนโปรแกรมก็ไม่ได้แสดงการปรับปรุงในทุกด้าน ในดัชนีเอเจนต์การเขียนโปรแกรมของ Artificial Analysis คะแนนของ GPT-6.2 Astra เท่ากับรุ่นก่อนหน้า ในขณะที่ GPT-6.2 Sol ลดลง 3 คะแนนเมื่อเทียบกับ GPT-6.1 Sol
ผลลัพธ์โดยละเอียดแสดงให้เห็นว่าคะแนนที่ลดลงของ Sol ส่วนใหญ่มาจาก SWE-Atlas-QnA-AA โดยลดลง 14 คะแนน การทดสอบนี้ประเมินความเข้าใจและความสามารถในการถามตอบเกี่ยวกับโค้ดเบสที่ซับซ้อน ผลการทดสอบบ่งชี้ว่า Sol มีแนวโน้มที่จะมองข้ามข้อเท็จจริงสำคัญเมื่อตอบคำถามเกี่ยวกับโค้ดเบสเมื่อเทียบกับรุ่นก่อนหน้า
นี่เป็นจุดที่นักพัฒนาที่ต้องจัดการโค้ดเบสขนาดใหญ่ที่สืบทอดมาควรให้ความสนใจ รุ่นสามารถเขียนโค้ดได้ แต่ไม่ได้หมายความว่าจะเข้าใจประวัติ การพึ่งพา และข้อจำกัดเฉพาะของโปรเจกต์อย่างแม่นยำ
05 ขอบเขตความปลอดภัย
เนื่องจากรุ่นสามารถใช้งานเทอร์มินัล ตรวจสอบโค้ด และเรียกใช้ซอฟต์แวร์ระดับมืออาชีพ ความเสี่ยงด้านความปลอดภัยทางไซเบอร์ก็เพิ่มขึ้นเช่นกัน
OpenAI เปิดเผยว่าทั้ง GPT-6.2 Astra และ Sol ถึง "เกณฑ์วิกฤต" ด้านความปลอดภัยทางไซเบอร์ที่กำหนดโดยกรอบการเตรียมพร้อมของบริษัท ทั้งสองรุ่นสามารถค้นพบและใช้ประโยชน์จากช่องโหว่ซอฟต์แวร์ได้อย่างมีประสิทธิภาพมากขึ้น รวมถึงเขียนโค้ดพื้นฐานที่ปลอดภัยยิ่งขึ้นและสร้างแพตช์ที่รักษาตรรกะทางธุรกิจเดิมให้มากที่สุด
นั่นหมายความว่าความสามารถเดียวกันนี้สามารถใช้ในการสแกนช่องโหว่และอาจใช้ในการโจมตีได้ ดังนั้น OpenAI จึงเพิ่มข้อจำกัดสำหรับเวอร์ชันสาธารณะในงานความปลอดภัยทางไซเบอร์ที่มีความเสี่ยงสูง
สำหรับนักวิจัยด้านความปลอดภัยที่ต้องทำการทดสอบช่องโหว่ ข้อจำกัดเหล่านี้จะส่งผลกระทบต่องานปกติบางอย่างด้วย ปัจจุบัน OpenAI กำลังเปิดความสามารถที่เกี่ยวข้องเป็นลำดับชั้นผ่านโครงการ Daybreak: ผู้ป้องกันสามารถใช้ GPT-6 Sol ที่มีอัตราการปฏิเสธต่ำกว่าผ่าน Daybreak Blue ส่วนผู้ทดสอบ red team ที่ได้รับอนุญาตขั้นสูงสามารถเรียกใช้เวอร์ชันอัลฟาของ GPT-6 Astra และ GPT-6 Cyber ใน Daybreak Red OpenAI ระบุว่าซีรีส์ GPT-6.2 จะถูกนำเข้าสู่ระบบนี้ในอนาคตด้วย
นอกจากนี้ OpenAI ยังรวมสัญญาณการฝึกที่เน้นการป้องกันในระหว่างขั้นตอนการฝึก ก่อนหน้านี้ AI ถูกใช้เพื่อค้นพบช่องโหว่ที่มีความเสี่ยงสูง เช่น PHP2Shell ซีรีส์ GPT-6.2 ช่วยเพิ่มความสามารถในการระบุข้อบกพร่องด้านความปลอดภัยจากแหล่งที่มาของการพัฒนา และเรียนรู้ที่จะสร้างแพตช์ที่สมดุลระหว่างความปลอดภัยและความสมบูรณ์ของฟังก์ชัน
เนื้อหานี้จัดทำขึ้นโดยมีวัตถุประสงค์เพื่อแจ้งข้อมูลและให้ความรู้เท่านั้น และไม่ถือว่าเป็นคำแนะนำด้านการลงทุนที่เกี่ยวข้องกับ BTCC แต่อย่างใด BTCC ใช้ความพยายามอย่างเต็มที่ แต่ไม่สามารถรับประกันความจริงแท้ ความถูกต้อง หรือความเป็นต้นฉบับของเนื้อหาข้างต้นได้