


Почему Nvidia снижает объём памяти, если дефицит ИИ-памяти не решается?
 Blockbeats
Возникает, казалось бы, противоречивый вопрос: если спрос на память для ИИ настолько высок, почему производители чипов начинают рассматривать сокращение объёма памяти? Означает ли «урезание» памяти, что спрос скоро достигнет пика, или это признак того, что дефицит поставок стал настолько серьёзным, что вынуждает всю отрасль менять технический курс?
Аналитики Morgan Stanley по полупроводникам Джозеф Мур и его коллеги в отчёте от 5 октября 2025 года «Как экосистема ИИ может обойти узкие места памяти?» (How Can the AI Ecosystem Work Around Memory Bottlenecks?) отметили, что дефицит памяти может сохраняться на протяжении всего текущего цикла ИИ, но развитие ИИ не будет ждать, пока заводы DRAM завершат расширение мощностей. Отрасли нужно обходить ограничения поставок, снижая конфигурации некоторых продуктов, разделяя задачи инференции и повышая эффективность совместного использования памяти.
Это означает, что конкуренция в сфере аппаратного обеспечения ИИ может сместиться с простого наращивания объёмов GPU и памяти на эффективность использования ресурсов всей вычислительной системы. Дефицит памяти не обязательно ослабляет долгосрочный спрос на продукцию производителей памяти, но может изменить распределение добавленной стоимости в цепочке поставок. Помимо Micron, SanDisk и других производителей памяти, компании с особыми вычислительными архитектурами и технологиями межсоединений, такие как Cerebras, Astera Labs и Marvell, также могут получить новые возможности для роста.
Ниже представлен адаптированный перевод оригинала:
Развитие инфраструктуры ИИ сталкивается со всё более трудно решаемой проблемой: вычислительные мощности можно наращивать за счёт закупки дополнительных GPU, но предложение памяти не может расти такими же темпами.
Morgan Stanley полагает, что в обозримом будущем спрос на память для ИИ, вероятно, будет продолжать поглощать значительные объёмы нового предложения памяти. Даже если уровень дефицита в разные периоды будет колебаться, расширение мощностей DRAM вряд ли быстро устранит разрыв между спросом и предложением.
В ходе общения с компаниями вычислительной отрасли Morgan Stanley обнаружил, что вопрос обхода узких мест в памяти становится всё более важной темой. Генеральный директор Nvidia Дженсен Хуанг также говорил о необходимости смягчения ограничений поставок за счёт совместной разработки вычислительных, сетевых систем и систем хранения.
Аналитики считают, что это не предупреждение об ослаблении спроса на память, а реальность, с которой вынуждена столкнуться вся индустрия ИИ: когда память не может быть поставлена по первоначальному графику, компании должны находить новые системные архитектуры, позволяющие существующему оборудованию продолжать поддерживать рост ИИ.
1. Nvidia начинает «урезать» Rubin, но проблема с памятью не исчезает
Наиболее прямой способ — сократить объём памяти, используемой одним сервером или одним GPU.
Morgan Stanley отмечает, что дефицит поставок и рост цен на DRAM и NAND вынуждают цепочку поставок ИИ пересматривать конфигурации продуктов. Для производителей чипов, вместо того чтобы настаивать на исходных спецификациях, что может привести к невозможности поставить системы в срок, лучше предложить версии с разным объёмом памяти, чтобы клиенты могли выбирать в соответствии с реальными потребностями.
В отчёте прогнозируется, что Nvidia, вероятно, предложит несколько конфигураций Rubin с меньшим объёмом памяти.
Что касается памяти на уровне стойки, первоначально планировавшийся объём LPDDR5 для Rubin составлял около 54 ТБ, а некоторые новые конфигурации могут быть снижены до 28 ТБ, что соответствует уменьшению ёмкости модулей памяти SOCAMM2 со 192 ГБ до 96 ГБ.
Что касается HBM, первоначально предполагалось, что один GPU Rubin будет оснащён 288 ГБ HBM4 с использованием 8 стеков по 12 слоёв; Morgan Stanley ожидает, что Nvidia может добавить версию продукта со 192 ГБ HBM4, уменьшив количество слоёв стека до 8.
Для Rubin Ultra в отчёте отмечается, что после перехода на схему с двумя вычислительными кристаллами 512 ГБ является более подходящей базой для сравнения, и в будущем могут появиться варианты ёмкости примерно от 192 ГБ до 384 ГБ.
Всё это является оценкой Morgan Stanley конфигураций продуктов на дату публикации отчёта, и не все спецификации были официально подтверждены Nvidia.
С точки зрения затрат такая стратегия имеет смысл. Уменьшение количества слоёв HBM снижает ёмкость, но при неизменных условиях, таких как количество интерфейсов и скорость выводов, теоретическая пропускная способность не обязательно снижается синхронно.
Однако ёмкость и пропускная способность решают две разные задачи. Для приложений с небольшими моделями и коротким контекстом снижение ёмкости может иметь ограниченное влияние; но когда модели становятся всё больше, а задачи инференции всё сложнее, нехватка объёма памяти всё равно может привести к необходимости переноса большего объёма данных между разными уровнями хранения, увеличивая задержку или загрузку GPU.
Что ещё важнее, сокращение HBM не устраняет данные, которые ИИ должен обрабатывать, а лишь заставляет эти данные искать новое место хранения.
Например, когда ёмкости HBM на GPU недостаточно, часть данных может потребоваться хранить в основной памяти; когда объём LPDDR5 на уровне стойки снижается, часть потребностей в KV-кэше может переключиться на флэш-память NAND.
KV-кэш — это кэш, используемый в процессе инференции больших моделей для хранения истории вычислений. С увеличением длины контекста и числа одновременно выполняемых запросов потребность в его ёмкости также растёт.
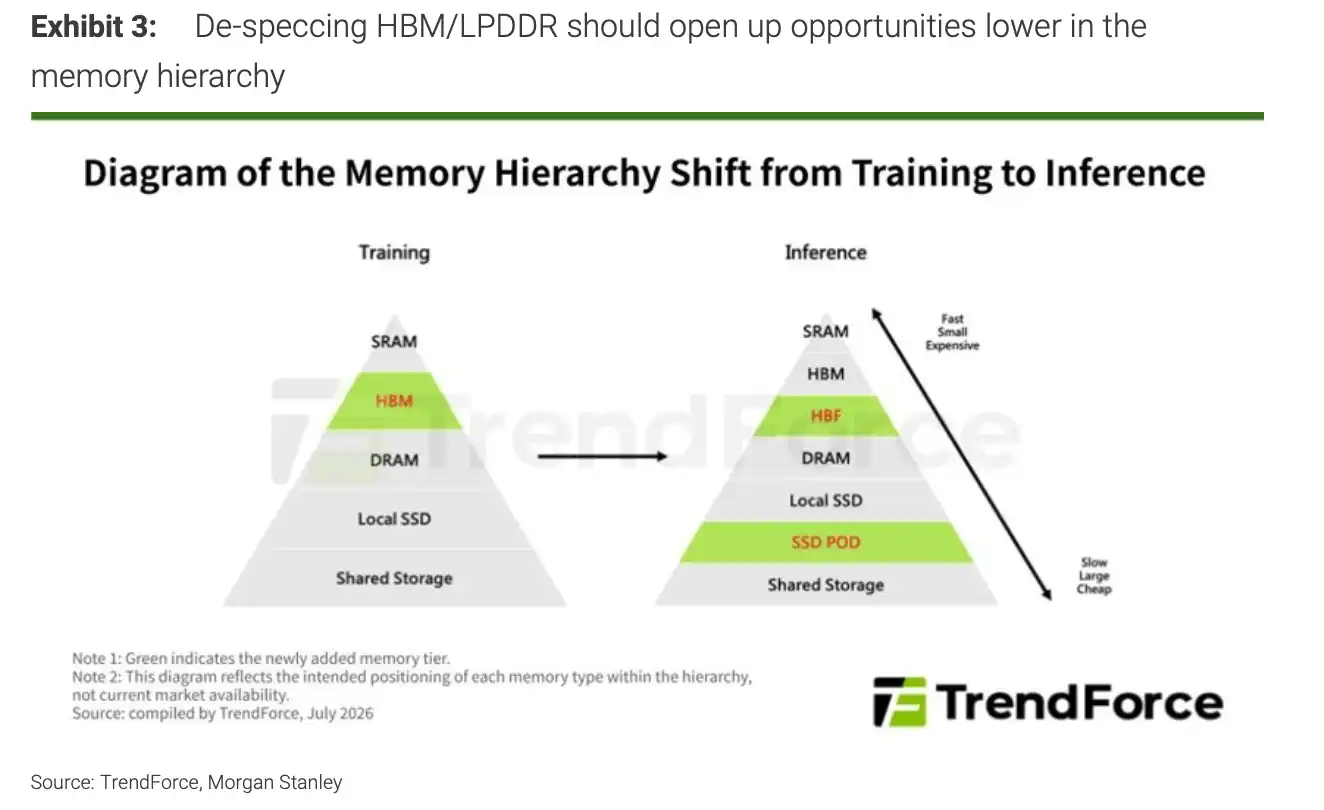
Потребность в памяти не исчезает, а переносится на другие уровни.
Morgan Stanley отмечает, что одновременно со снижением Nvidia части конфигураций LPDDR5 в цепочке поставок уже наблюдается новый спрос на NAND. Сокращение ёмкости HBM может также увеличить объём передачи данных между GPU, создавая большую нагрузку на высокоскоростные сети межсоединений.
Это означает, что стратегия Nvidia по снижению конфигураций может временно ослабить ограничения поставок DRAM, но одновременно увеличит спрос на NAND, чипы межсоединений и более крупные кластеры GPU.
Такой перенос нагрузки имеет долгосрочную подоплёку.
Согласно историческим данным Epoch AI, приведённым в отчёте, масштаб параметров передовых моделей в эпоху больших языковых моделей демонстрировал тенденцию к удвоению примерно каждые шесть месяцев. Контекстные окна также быстро расширялись. Кроме того, всё больше приложений ИИ переходят от простых вопросов и ответов к программированию, сложным рассуждениям и длительным агентным задачам, что ещё больше увеличивает использование памяти.
Morgan Stanley считает, что размер моделей, длина контекста и объём параллельной инференции будут продолжать стимулировать рост спроса на память. Поэтому снижение конфигураций части продуктов, скорее всего, является переходным решением на период дефицита поставок, а не сигналом долгосрочного снижения спроса на память для ИИ.
2. Инференцию ИИ начинают «разделять», GPU больше не выполняют все задачи
Если сокращение конфигураций памяти — это краткосрочная мера, то изменение способа вычислений при инференции ИИ может привести к более глубоким изменениям в отрасли.
Второй путь, на который обращает внимание Morgan Stanley, — это Disaggregated Inference (дезагрегированная инференция), то есть разделение различных задач инференции, изначально сосредоточенных в одной вычислительной системе, и передача их более подходящему оборудованию.
Традиционная инференция больших моделей в основном включает два этапа.
Первый этап — Prefill (предварительное заполнение), то есть обработка введённых пользователем подсказок, документов или исторического контекста с выполнением большого объёма параллельных вычислений. Этот этап обычно больше зависит от вычислительной производительности.
Второй этап — Decode (декодирование), то есть модель генерирует выходные токены один за другим. Этот процесс требует многократного доступа к весам модели и KV-кэшу, поэтому он больше зависит от пропускной способности памяти, её ёмкости и задержки доступа к данным.
Раньше одни и те же GPU часто одновременно выполняли оба типа задач. Но по мере роста потребностей в инференции такая конфигурация не всегда является наиболее эффективным выбором.
Morgan Stanley считает, что более разумным направлением может быть передача Prefill оборудованию, ориентированному на вычисления, а Decode — архитектурам, оптимизированным под низкую задержку и высокую пропускную способность.
Такой подход не только повышает загрузку оборудования, но и позволяет дата-центрам раздельно масштабировать два типа вычислительных ресурсов, не оснащая все задачи одинаковыми GPU и HBM.
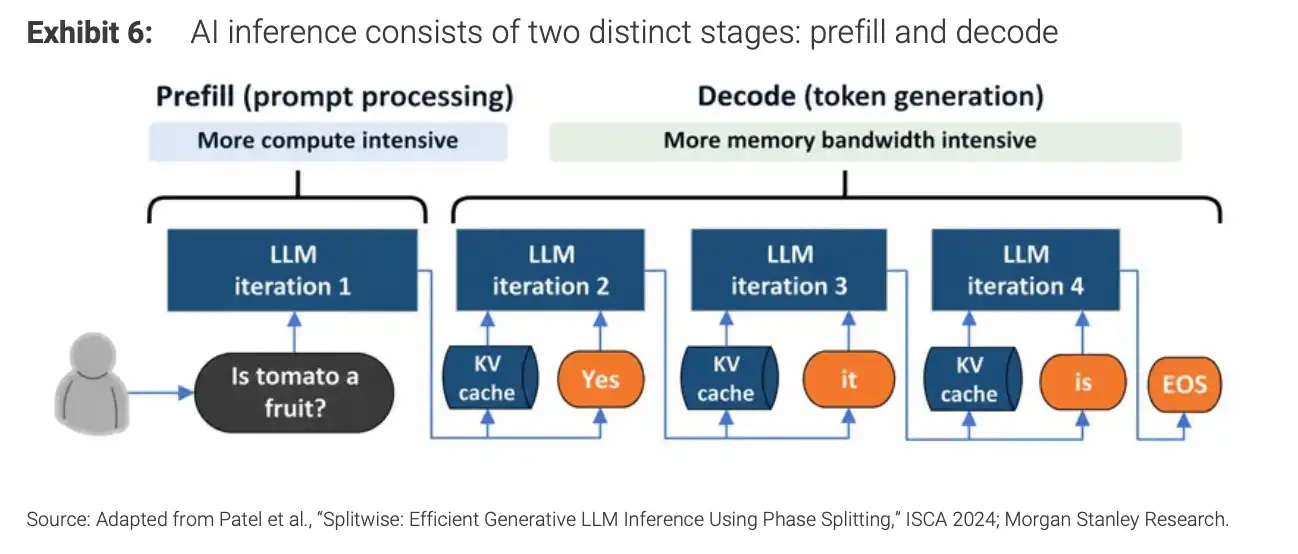
Технические различия между Prefill и Decode
Одним из наиболее прямых потенциальных бенефициаров является Cerebras.
Cerebras использует архитектуру процессора на уровне пластины, объединяя большое количество вычислительных блоков и SRAM на одном чипе. SRAM (статическая память с произвольным доступом) обычно имеет меньшую плотность ёмкости, чем DRAM, но отличается низкой задержкой и высокой пропускной способностью, что подходит для некоторых задач инференции, требующих частого чтения данных.
Благодаря размещению вычислительных блоков ближе к данным Cerebras может сократить потребность во внешней памяти и повысить скорость обработки определённых этапов инференции.
Morgan Stanley отмечает, что Cerebras уже сотрудничает с AMD и AWS, изучая возможность объединения различных процессоров в единую систему инференции.
В совместном решении AMD и Cerebras AMD Helios отвечает за более вычислительно интенсивный Prefill и обработку длинного контекста, а движок Cerebras на уровне пластины — за Decode. В отчёте прогнозируется, что это решение выйдет на стадию производства в четвёртом квартале 2026 года.
AWS использует аналогичный подход: Trainium обрабатывает Prefill, а Cerebras — Decode; ожидается, что соответствующее комбинированное решение появится в Amazon Bedrock в первом квартале 2027 года.
Согласно данным о производительности конкретных решений, раскрытым Cerebras и AMD, их сочетание может обеспечить до пятикратного увеличения пропускной способности при сохранении скорости инференции Cerebras. Это не означает, что все задачи инференции получат такое же улучшение, но показывает, что конфигурирование оборудования под разные задачи может значительно улучшить экономику системы.
Для Cerebras это изменение означает не только больше возможностей для продажи чипов. Поскольку компания также управляет собственным облачным сервисом инференции, если то же оборудование сможет генерировать больше токенов, стоимость одного токена может снизиться, что улучшит валовую маржу или создаст пространство для снижения цен для клиентов.
Nvidia также изучает аналогичное направление.
Интегрируя технологии Groq, Nvidia объединяет GPU на базе HBM с архитектурой LPU на высокоскоростной SRAM. В описанной в отчёте схеме GPU Rubin отвечает за Prefill и часть вычислений декодирования, требующих большого объёма кэша, а архитектура Groq берёт на себя вычисления, более подходящие для её низкой задержки; программное обеспечение NVIDIA Dynamo координирует задачи между разными процессорами.
Следует различать, что в 2025 году Nvidia и Groq достигли соглашения о лицензировании технологий и привлечении специалистов, а не о полном приобретении компании Groq.
Morgan Stanley считает, что по мере того, как рост расходов на инференцию превышает рост расходов на обучение, гетерогенные вычислительные архитектуры, оптимизированные под разные этапы инференции, могут получить большее рыночное пространство. Согласно прогнозу расходов на инфраструктуру в отчёте, к 2030 году на инференцию будет приходиться около 56% расходов на инфраструктуру ИИ, а на обучение — около 44%.
Это также привносит новую логику конкуренции в индустрию чипов для ИИ: в будущем показателями конкурентоспособности системы ИИ могут быть не только пиковая вычислительная мощность, но и количество генерируемых токенов в секунду, а также стоимость генерации каждого токена.
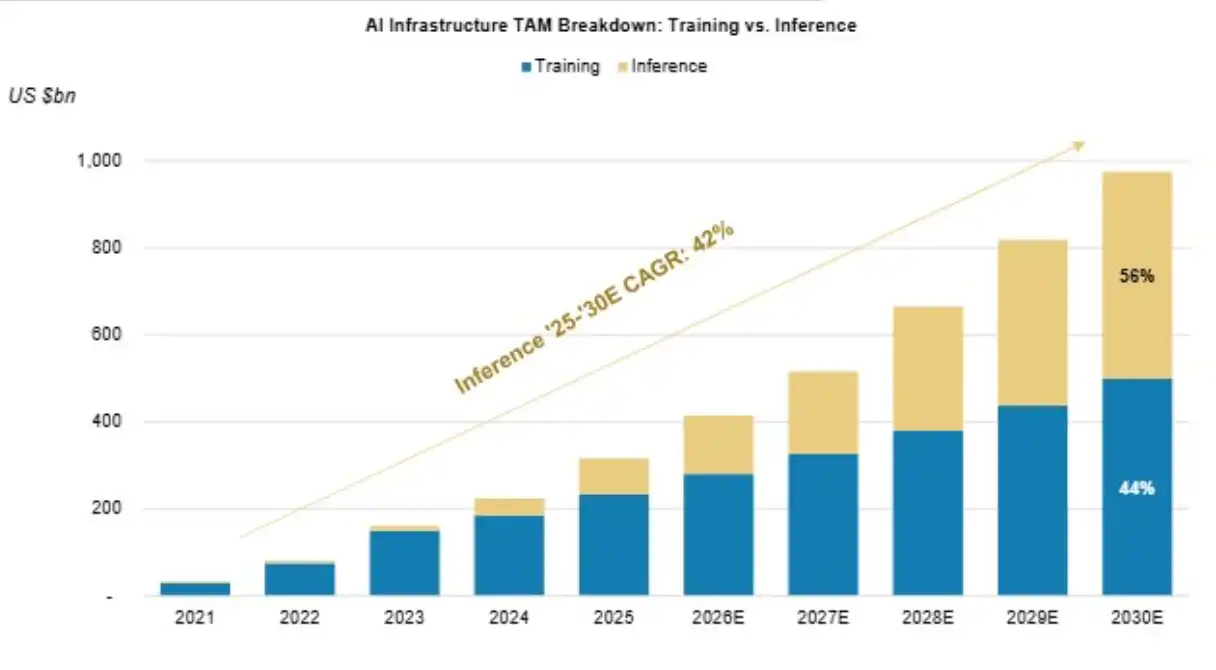
3. Рынок CXL может достичь 6 млрд долларов, межсоединения памяти становятся новой возможностью
Помимо изменения способа распределения задач инференции, Morgan Stanley уделяет особое внимание тому, как повысить эффективность использования существующих ресурсов памяти. Именно здесь кроется возможность для технологии CXL.
CXL (Compute Express Link, высокоскоростное вычислительное межсоединение) — это протокол высокоскоростного межсоединения, который позволяет процессорам более гибко обращаться к внешней памяти, не полагаясь постоянно на локально подключённую DRAM.
В традиционных серверах ресурсы памяти часто привязаны к конкретному CPU. Даже если на одном сервере имеется большой объём неиспользуемой памяти, её трудно напрямую использовать на другом сервере. CXL же за счёт расширения, совместного использования и пулинга памяти повышает общую утилизацию DRAM в дата-центре. Расширение памяти может предоставить одному процессору дополнительную ёмкость; совместное использование памяти позволяет нескольким процессорам обращаться к одним и тем же ресурсам памяти; пулинг памяти организует разрозненную память в единый пул ресурсов, динамически распределяемый в зависимости от рабочей нагрузки.
Ранее эта технология в основном применялась в традиционных вычислительных средах на базе CPU, поскольку рабочие нагрузки CPU относительно легче переносят дополнительную задержку доступа, связанную с внешней памятью. В отличие от этого, GPU для ИИ долгое время полагались на HBM для обеспечения чрезвычайно высокой пропускной способности данных, и внешняя DRAM, подключённая через CXL, не может напрямую заменить HBM.
Но по мере изменения потребностей инференции ИИ ценность такой архитектуры растёт.
Например, инференция с длинным контекстом требует хранения большого объёма KV-кэша, но не все кэшированные данные должны постоянно находиться в самой быстрой HBM. Система может хранить данные, чувствительные к производительности, в HBM, а часть данных с меньшей частотой доступа и относительно менее строгими требованиями к задержке переносить во внешнюю DRAM.
Это позволяет как снизить нагрузку на ёмкость дорогой HBM, так и повысить эффективность использования существующей DRAM.
Morgan Stanley считает, что ИИ способствует переходу CXL от расширения памяти традиционных серверов к более широкому рынку подключения и совместного использования памяти ускорителей.
Ранее Astera Labs оценивала потенциальный объём рынка контроллеров памяти CXL более чем в 4 млрд долларов. Morgan Stanley в настоящее время прогнозирует, что с ростом спроса на инференцию ИИ, разгрузку KV-кэша и пулинг памяти на уровне стойки к 2030 году потенциальный объём рынка CXL и связанных с ними полупроводников для подключения памяти может достичь примерно 6 млрд долларов.
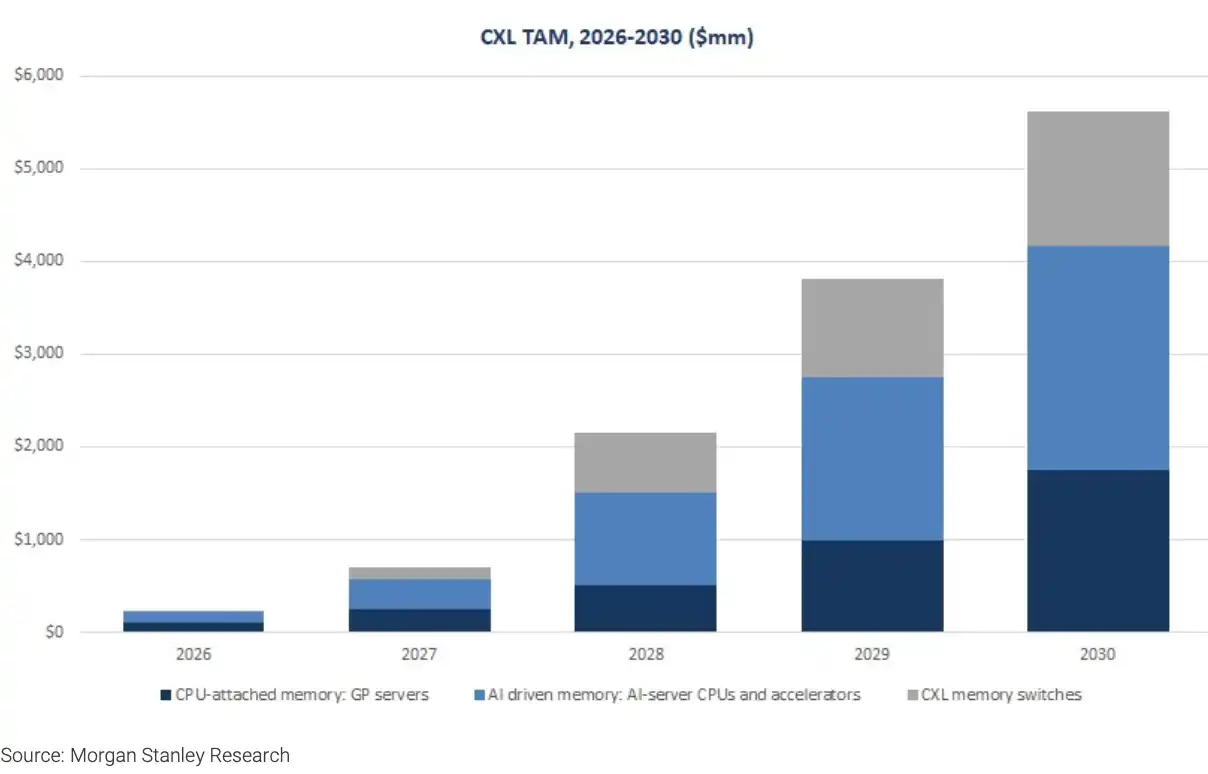
Следует подчеркнуть, что эта цифра является прогнозом аналитиков относительно потенциального объёма рынка, а не уже полученной выручкой.
Что касается конкретных компаний, в отчёте основное внимание уделяется Astera Labs (ALAB) и Marvell (MRVL).
Возможности Astera Labs в основном связаны с продуктом контроллера памяти Leo. Morgan Stanley отмечает, что компания ожидает, что стандартизированные и кастомизированные продукты Leo начнут масштабно внедряться у двух крупных американских клиентов облачных сервисов в 2027 году, включая дизайн разгрузки KV-кэша для инференции ИИ.
Marvell, в свою очередь, через Structera X и Structera S развивает направления расширения памяти и пулинга памяти на уровне стойки. Ранее компания прогнозировала, что бизнес CXL может принести более 1 млрд долларов выручки примерно к 2028 году.
Для этих двух компаний дефицит памяти для ИИ может дать новый коммерческий спрос на технологию CXL, которая ранее продвигалась медленно.
Однако Morgan Stanley также признаёт, что реальный масштаб рынка CXL по-прежнему трудно точно предсказать. Разные облачные провайдеры могут выбрать технологии межсоединений, отличные от CXL, HBM большей ёмкости или схемы кэширования на основе флэш-памяти, и конечная скорость внедрения на рынке может существенно отличаться от текущих ожиданий.
Поэтому, сможет ли инвестиционная логика CXL реализоваться, ещё предстоит наблюдать за фактическим прогрессом развёртывания у облачных провайдеров, объёмами поставок продукции и соответствующей выручкой.
4. Снижение конфигураций памяти не обязательно негативно для Micron, реальный риск — замедление развития ИИ
Для цепочки поставок памяти снижение Nvidia части конфигураций памяти, казалось бы, не является хорошей новостью. Если ёмкость HBM на один GPU снижается, а использование LPDDR5 на одну стойку уменьшается, производители памяти могут продать меньше памяти, чем планировалось изначально.
Morgan Stanley признаёт, что с точки зрения краткосрочной максимизации прибыли это действительно может ослабить часть спроса и ценовых возможностей, которые производители памяти могли бы получить. Однако аналитики считают, что это не следует упрощённо трактовать как признак окончания цикла памяти. Ключевой момент в том, что текущее снижение конфигураций в основном вызвано ограничениями поставок, а не тем, что клиентам больше не нужно столько памяти.
Когда компании, занимающиеся ИИ, хотят закупить больше DRAM, но не могут получить достаточное предложение, снижение конфигураций помогает им поддерживать поставки систем. После увеличения предложения в будущем у производителей всё равно будет стимул снова повысить уровень конфигураций. Это означает, что текущий неудовлетворённый спрос может сформировать определённый объём последующих закупок.
Исходя из этого суждения, Morgan Stanley больше внимания уделяет продолжительности цикла подъёма в отрасли памяти, а не максимальной амплитуде краткосрочного роста цен. Если модели ИИ продолжат расширяться, количество агентных приложений будет расти, а объём параллельной инференции продолжит увеличиваться, то даже если производители DRAM нарастят мощности, новое предложение может быть быстро поглощено.
Поэтому Morgan Stanley сохраняет рейтинг Overweight (выше рынка) для Micron (MU) и SanDisk (SNDK), полагая, что дефицит поставок памяти не закончится быстро.
Но это не означает, что отрасль памяти может полностью избежать циклических рисков. В отчёте отмечается, что самый главный риск по-прежнему связан с самим спросом на ИИ. Если темпы роста разработки моделей, приложений инференции или инвестиций в вычислительные мощности заметно снизятся, это может ударить по всей цепочке поставок вычислений и памяти.
Кроме того, существует более сложный сценарий: спрос на ИИ остаётся высоким, но строительство дата-центров задерживается из-за ограничений по земле, электроэнергии или инфраструктуре. В такой ситуации продукты памяти могут быть уже произведены, но не могут быть использованы по плану из-за задержки развёртывания серверов, что приведёт к временному дисбалансу спроса и предложения.
Morgan Stanley считает, что такие узкие места в строительстве могут создавать дополнительные помехи для производителей памяти и даже приводить к расхождению их краткосрочных показателей с показателями некоторых производителей вычислительных чипов. Поэтому в будущем для оценки того, продолжится ли цикл памяти, нельзя ориентироваться только на цены DRAM и заказы на HBM, необходимо также отслеживать фактический прогресс развёртывания инфраструктуры ИИ.
Конечным следствием дефицита памяти для ИИ может стать не сокращение использования памяти отраслью, а необходимость заново решать: какие данные должны оставаться в HBM, какие можно перенести в DRAM или NAND, и какие вычислительные задачи следует передавать чипам разных типов.
Для инвесторов ключевые переменные, за которыми нужно следить, также постепенно проясняются: будут ли снижены фактические конфигурации поставок Rubin, сможет ли дезагрегированная инференция достичь коммерческого масштаба развёртывания, смогут ли продукты CXL выйти на запланированные объёмы в 2027 году, и продолжит ли строительство дата-центров ИИ поглощать новое предложение памяти.
Если эти технические корректировки смогут поддерживать развёртывание систем ИИ, а долгосрочный спрос на память продолжит расти, то цепочки поставок памяти и межсоединений могут выиграть совместно; но если инвестиции в ИИ замедлятся или ограничения по электроэнергии и земле продолжат препятствовать вводу дата-центров в эксплуатацию, текущая напряжённость спроса и предложения может столкнуться с переоценкой.
Именно это является наиболее важным выводом Morgan Stanley относительно текущего цикла памяти для ИИ: отрасли действительно нужно решить не то, как дождаться увеличения объёма памяти, а то, как продолжать наращивать вычислительные мощности ИИ в условиях, когда память всегда будет дефицитной.
Данный контент предназначен исключительно для информационных и образовательных целей и не является инвестиционным советом, связанным с BTCC. BTCC прилагает все усилия, но не может гарантировать правдивость, точность или оригинальность вышеприведенного контента.