Lanzamiento de GPT-6.2: replica PPT, crea modelos de valoración y modelado 3D, pero la tasa de alucinación sigue en el 59%
 chaincatcher
Artículo | Xiaojing
Editor | Xu Qingyang
El 17 de noviembre, hora local de Estados Unidos, OpenAI lanzó oficialmente GPT-6.2 Astra y GPT-6.2 Sol.
Este lanzamiento llegó más tarde de lo esperado. Ya a finales de octubre, algunos usuarios habían descubierto rastros de un posible GPT-6.2 en los registros de uso de ChatGPT, y desde entonces se han filtrado continuamente identificadores del modelo y capturas de pantalla de pruebas. Anteriormente, los medios habían predicho que el nuevo modelo se lanzaría como muy pronto el 6 de noviembre, pero la fecha final de lanzamiento fue 11 días después de esa expectativa.
OpenAI enfatizó esta vez la capacidad de la IA para asumir trabajos profesionales.
Desde replicar una presentación completa a partir de una captura de pantalla de PPT, hasta extraer datos financieros, construir modelos de valoración, operar Blender para generar modelos 3D de automóviles, simular el movimiento físico de suspensiones de vehículos e incluso usar CAD para diseñar piezas mecánicas y verificar relaciones de ensamblaje, GPT-6.2 ha comenzado a adentrarse en tareas que antes requerían que profesionales usaran software complejo.
OpenAI destacó especialmente que el nuevo modelo puede reducir las salidas ineficaces y las modificaciones repetidas, haciendo que los resultados entregados por la IA se acerquen más a los estándares del trabajo profesional.
En los últimos dos meses, OpenAI ha lanzado sucesivamente modelos como GPT-6 Astra, Sol y Luna, así como GPT-6.1 Sol y Terra. El recién lanzado GPT-6.2 Astra es una actualización del modelo insignia tras GPT-6 Astra en septiembre, centrada en mejorar el manejo de tareas profesionales complejas; GPT-6.2 Sol fortalece principalmente la eficiencia en el trabajo diario, la programación y las tareas de agentes de varios pasos.
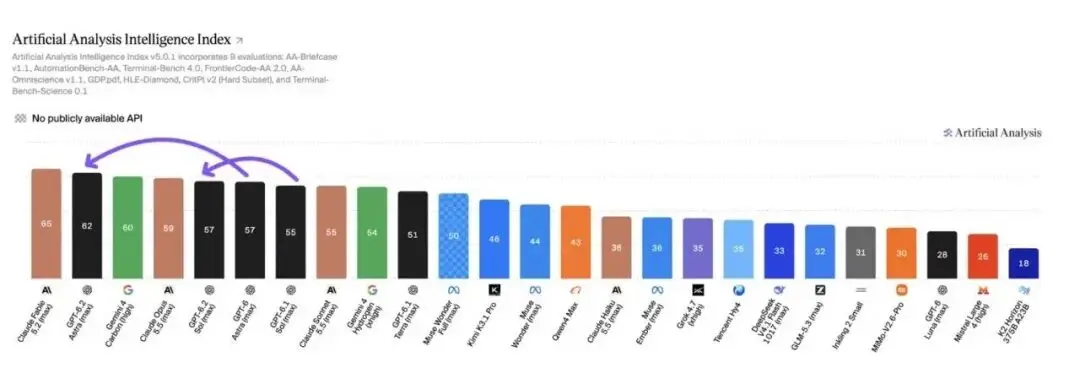
Según la última lista de Artificial Analysis, Astra subió al segundo lugar mundial con una puntuación de 62, un aumento de 5 puntos respecto a la generación anterior; Sol alcanzó una puntuación de 57. En cuanto a precios, tanto el precio unitario de entrada como el de salida de la API de Astra se redujeron un 20%, y el precio de entrada en caché bajó un 60%; Sol mantuvo su precio original, pero el coste total de completar ciertas tareas disminuyó aún más.
Cabe destacar que GPT-6.2 Astra es también el primer modelo evaluado públicamente de OpenAI en alcanzar el umbral de capacidad "Alta" para la mejora autónoma de la IA.
Sin embargo, las impresionantes demostraciones y puntuaciones también han atraído críticas mixtas. El día del lanzamiento, varios desarrolladores que habían probado el nuevo modelo con semanas de antelación expresaron públicamente su decepción, considerando que Astra podría detenerse prematuramente durante tareas de desarrollo de software a largo plazo, y que las salidas demasiado concisas a veces omiten información necesaria.
Al mismo tiempo, a medida que las capacidades del modelo se acercan más al trabajo profesional real, los límites de sus capacidades y los controles de seguridad también se han convertido en aspectos destacados importantes de este lanzamiento.
Sam Altman, CEO de OpenAI. Imagen generada por IA
01 Rendimiento y coste
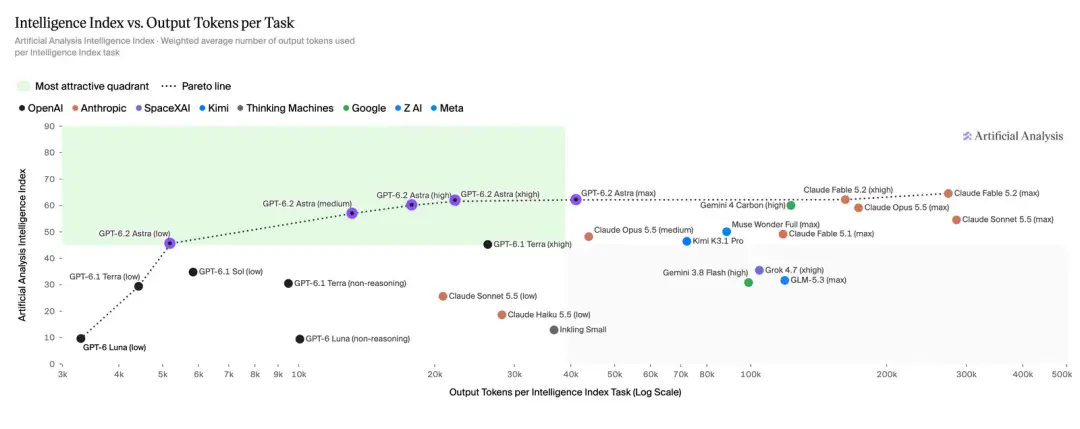
El precio de la API de GPT-6.2 Astra es de 8 dólares por millón de tokens de entrada y 40 dólares por millón de tokens de salida, con entrada en caché a 0,40 dólares. En comparación con la generación anterior, tanto los precios de entrada como de salida han disminuido un 20%, y la entrada en caché ha bajado de 1 dólar a 0,40 dólares, una reducción del 60%. GPT-6.2 Sol mantiene un precio de 2 dólares por millón de tokens de entrada y 10 dólares por millón de tokens de salida.
Para agentes de varios pasos, el precio unitario de la API no refleja completamente los gastos reales. Cuando el modelo ejecuta tareas, puede requerir múltiples llamadas a herramientas, lectura de archivos, manejo de errores y reintentos. Incluso si el precio unitario no cambia, si se necesitan menos tokens para completar la tarea, la factura final disminuirá en consecuencia.
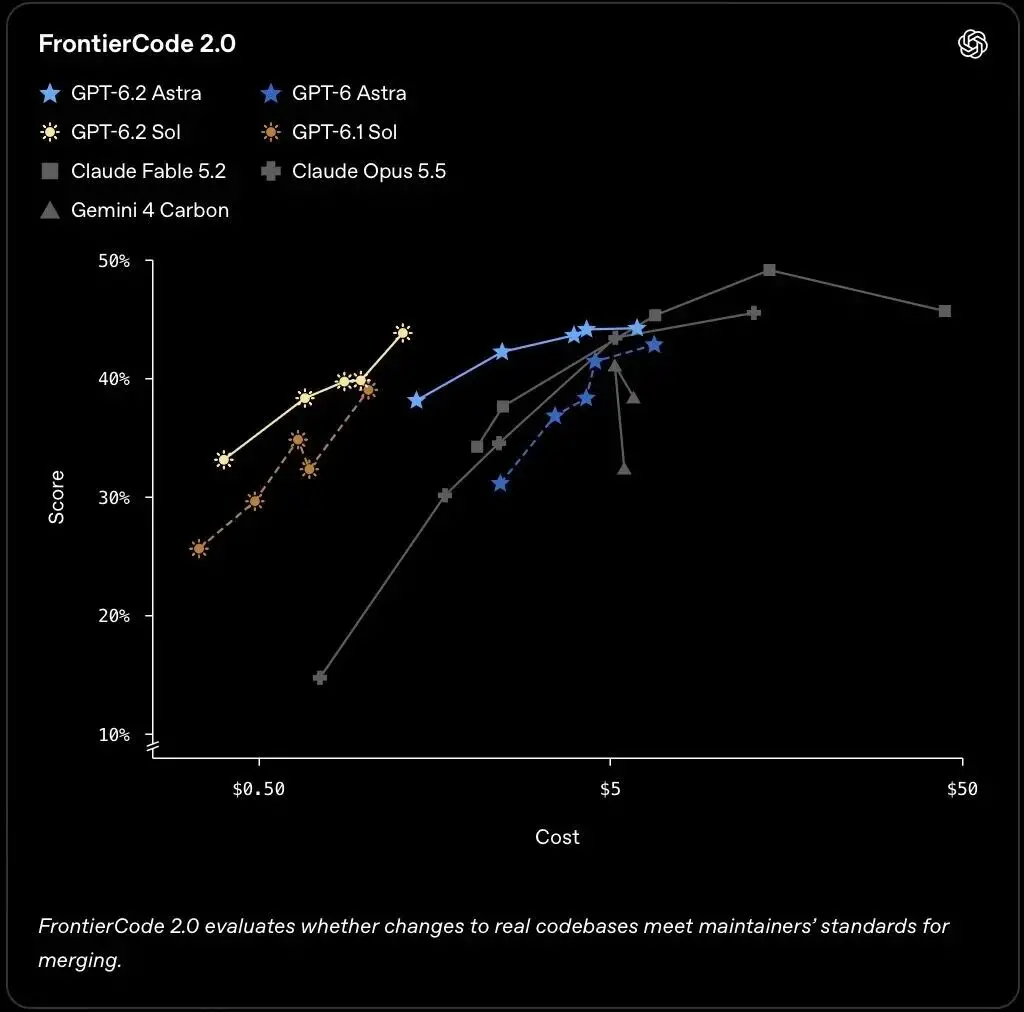
En la prueba de programación FrontierCode 2.0 de Cognition, GPT-6.2 Sol obtuvo solo 0,5 puntos menos que Astra, con costes aproximadamente una quinta parte de este último. En la evaluación LifeVal dirigida a tareas complejas diarias, la puntuación de Sol superó al anterior buque insignia GPT-6 Astra, con el coste de tareas individuales siendo aproximadamente una séptima parte de este último.
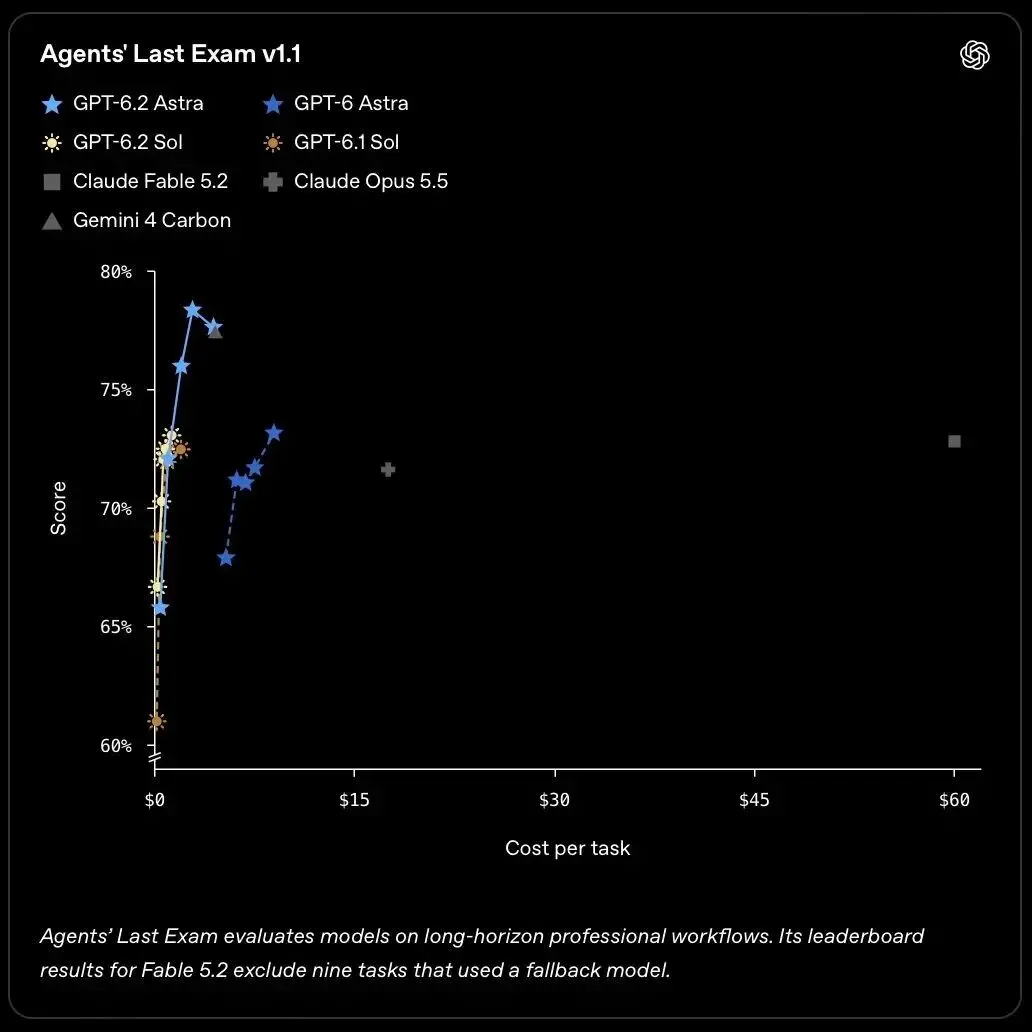
Astra también mostró mejoras en tareas de alta dificultad. En la evaluación Agents' Last Exam, mejoró 5,2 puntos en comparación con GPT-6 Astra, con el coste de completar tareas siendo menos de un tercio de la generación anterior. En comparación con Claude Fable 5.2, Astra obtuvo 5,5 puntos más, con el coste de tareas individuales siendo aproximadamente el 5% de este último.
02 Entrega de trabajo profesional
El trabajo profesional en finanzas, derecho y consultoría requiere que la IA maneje una gran cantidad de datos brutos, verifique información y produzca entregables según los estándares de la industria. OpenAI declaró que GPT-6.2 Astra ha mejorado en estas tareas, capaz de realizar modelado financiero, análisis de fusiones, investigación jurídica y análisis de ciencia de datos.
La prueba interna GDPval v2 de OpenAI cubre campos como consultoría, finanzas y diseño, con la puntuación de Astra mejorando 6,2 puntos porcentuales en comparación con la generación anterior, y los tokens de salida reducidos en un 22%.
En investigación jurídica, en la prueba Harvey LAB-AA v1.1 que simula tareas reales de bufetes de abogados, la tasa de aprobación de Astra superó a la de Claude Fable 5.2 en más del doble, con el coste de tareas individuales siendo aproximadamente una sexta parte de este último.
La prueba interna GDPval v2 de OpenAI también cubre trabajos de consultoría, finanzas y diseño. Los resultados de la prueba mostraron que la puntuación de Astra mejoró 6,2 puntos porcentuales en comparación con la generación anterior, con los tokens de salida reducidos en un 22%.
03 Entrando en el mundo 3D
Otra capacidad demostrada por GPT-6.2 Astra es la participación directa en modelado 3D y diseño de ingeniería. El modelo ya no solo genera un fragmento de código de modelado; también puede operar software profesional, manejar piezas, ajustar estructuras y crear contenido visual a partir de resultados computacionales.
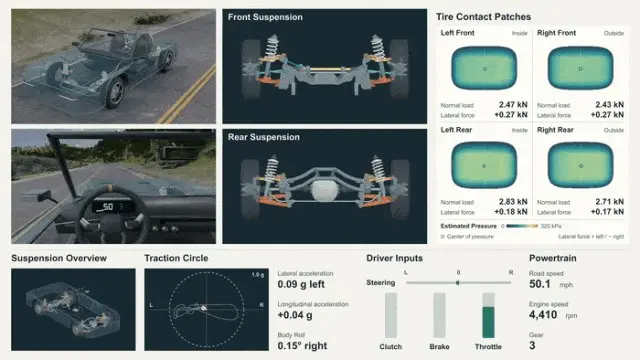
GPT-6.2 Astra simulando conducción en carretera de montaña y dinámica del chasis
En el caso de simulación de conducción en carretera de montaña, Astra primero estableció un modelo 3D de un automóvil deportivo, luego escribió un solucionador de física en Python para calcular la fuerza de los neumáticos sobre el suelo y los cambios dinámicos en el sistema de suspensión, y finalmente importó los resultados del cálculo a Blender para generar animaciones de conducción del vehículo. Mediante la simulación, los ingenieros pueden observar las situaciones de transferencia de carga cuando el vehículo atraviesa condiciones de carretera complejas antes de fabricar un prototipo físico.
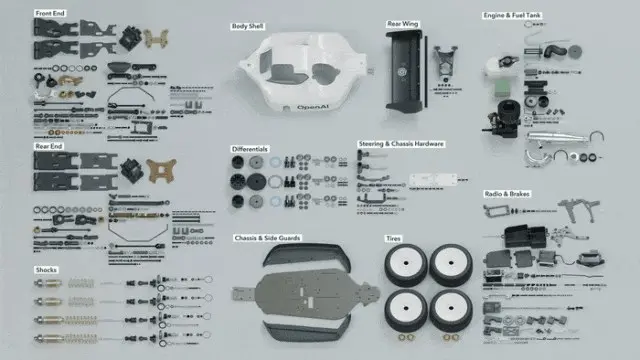
Los datos de entrada para el caso de modelado mecánico fueron mucho más simples. OpenAI solo proporcionó fotos públicas y manuales de ensamblaje de un vehículo todoterreno de control remoto a escala 1:8 y un motor de seis cilindros en línea. Basándose en esto, Astra estableció modelos 3D de varias piezas mecánicas y generó animaciones de ensamblaje paso a paso y catálogos ilustrados de piezas.
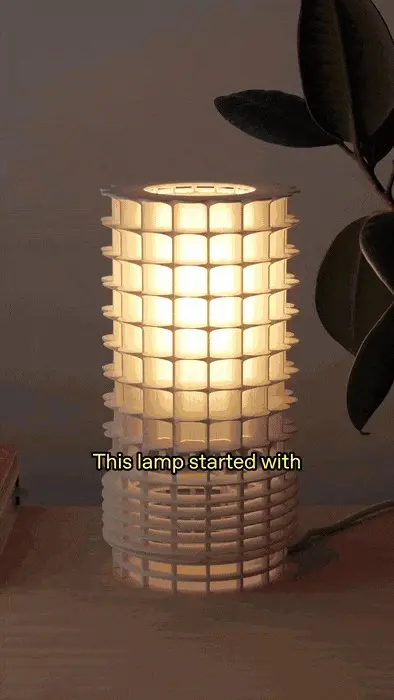
Una prueba también vinculó el diseño CAD con la producción real. El equipo de OpenAI proporcionó fotos del balcón en forma de abanico del emblemático edificio Marina City de Chicago para que el modelo las usara como referencia en su diseño. Después de varios ajustes, Astra finalmente creó una lámpara de mesa de arte en papel que se puede imprimir y ensamblar, y escribió una página web de apoyo llamada Lamp Builder para que los usuarios ajusten parámetros en línea y generen dibujos personalizados.
GPT-6.2 Astra completando el modelado mecánico del vehículo todoterreno de control remoto y el motor
En desarrollo web, Astra creó un configurador interactivo para una furgoneta camper. Los usuarios pueden cambiar el color de la carrocería y añadir una tienda de campaña en el techo, con la cotización de la página actualizándose en tiempo real. También generó mesas de pinball jugables, un modelo del Coliseo Romano y un juego de carreras de ciudad futurista llamado "Meridian Sound Racing" basado en descripciones de texto.
Del edificio Marina City de Chicago a la lámpara de mesa de arte en papel
La prueba ciega de evaluación humana AA-3D de Artificial Analysis también comparó las capacidades de generación 3D del modelo. GPT-6.2 Astra obtuvo 1318 puntos Elo, ocupando el primer lugar; Claude Fable 5.2 obtuvo 1271 puntos, y GPT-6.2 Sol obtuvo 1259 puntos.
El configurador interactivo para la furgoneta camper generado por GPT-6.2 Astra
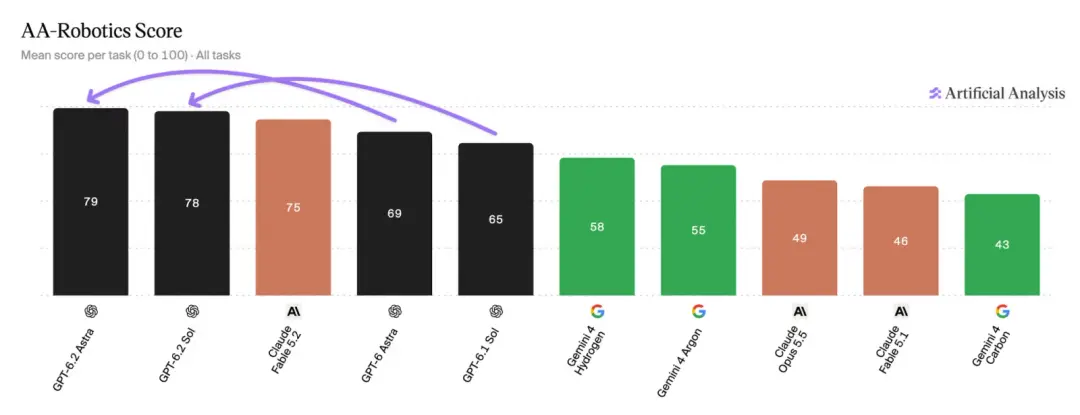
En la prueba preliminar AA-Robotics v0.1 que evalúa la comprensión del mundo físico y las capacidades de planificación de acciones, Astra y Sol obtuvieron 79 y 78 puntos respectivamente, superiores a los 75 puntos de Claude Fable 5.2. Sin embargo, el equipo de evaluación declaró que los modelos líderes ahora son capaces de completar la gran mayoría de las tareas básicas en las pruebas iniciales y están aumentando la dificultad de las preguntas.
04 Razonamiento científico y deficiencias
La investigación científica también fue un foco clave de la demostración de OpenAI esta vez.
En la prueba Terminal-Bench-Science 0.1, GPT-6.2 Astra mejoró 9 puntos porcentuales en comparación con la generación anterior, ocupando el primer lugar. Esta prueba evalúa principalmente la capacidad del modelo para completar flujos de trabajo científicos en entornos de terminal. En el Vals Science Index, que requiere que el modelo interprete datos biológicos reales, diseñe experimentos e infiera mecanismos del sistema, Astra también estableció un nuevo máximo.
Los resultados de varias otras pruebas fueron ligeramente inferiores a Claude Fable 5.2. En el subconjunto de alta dificultad del punto de referencia de razonamiento físico CritPt v2, la evaluación de conocimiento factual AA-Omniscience v1.1 y el punto de referencia de razonamiento HLE-Diamond, Astra ocupó el segundo lugar.
Un problema que aún existe con el modelo es que puede proporcionar respuestas incorrectas cuando se enfrenta a hechos inciertos.
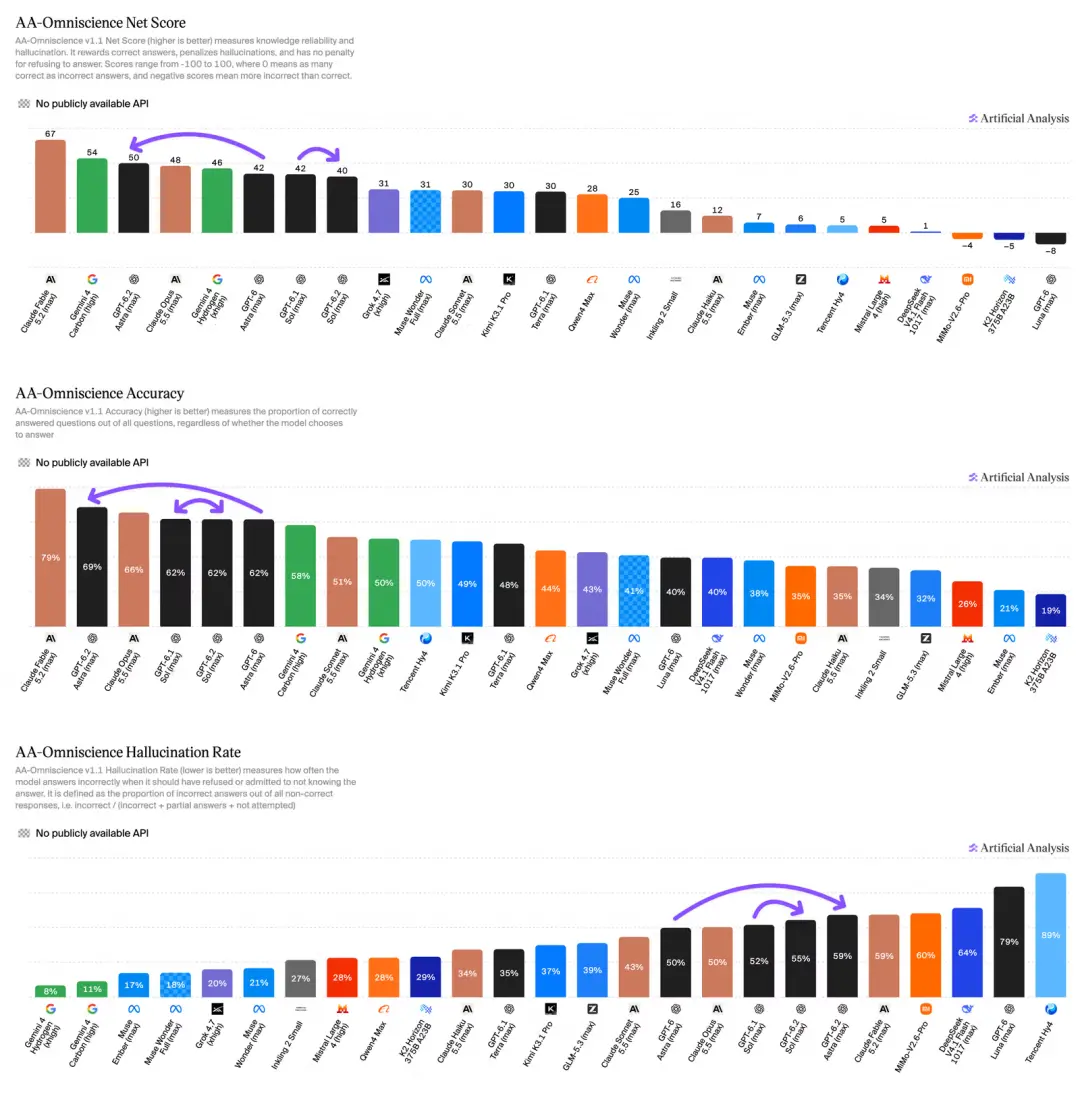
La prueba de tasa de alucinación de AA-Omniscience de Artificial Analysis muestra que a la máxima intensidad de razonamiento, las tasas de alucinación para GPT-6.2 Astra y Sol son del 59% y 55%, respectivamente. Esta prueba examina principalmente si el modelo tiende a adivinar respuestas cuando se enfrenta a preguntas factuales para las que puede no tener respuestas. No representa la tasa de error del modelo en preguntas y respuestas generales, pero para escenarios como auditoría financiera y referencias legales, la verificación manual sigue siendo necesaria.
Las pruebas de programación tampoco mostraron una mejora integral. En el índice de agentes de programación de Artificial Analysis, la puntuación de GPT-6.2 Astra está a la par con su predecesor, mientras que GPT-6.2 Sol ha bajado 3 puntos en comparación con GPT-6.1 Sol.
Los resultados detallados muestran que la pérdida de puntuación de Sol proviene principalmente de SWE-Atlas-QnA-AA, con una disminución de 14 puntos. Esta prueba evalúa la comprensión del modelo y la capacidad de preguntas y respuestas sobre bases de código complejas. Los resultados de la prueba indican que Sol es más propenso a pasar por alto hechos clave al responder preguntas relacionadas con bases de código en comparación con su predecesor.
Este es un punto al que los desarrolladores que necesitan manejar grandes bases de código heredadas deben prestar atención. El modelo puede escribir código, pero eso no significa que haya captado con precisión el historial del proyecto, las dependencias y las restricciones específicas.
05 Límites de seguridad
A medida que el modelo puede operar terminales, revisar código y llamar a software profesional, los riesgos de ciberseguridad también han aumentado.
OpenAI reveló que tanto GPT-6.2 Astra como Sol han alcanzado el "umbral crítico" de ciberseguridad establecido por el Marco de Preparación de la compañía. Ambos modelos pueden descubrir y explotar vulnerabilidades de software de manera más eficiente, así como escribir código subyacente más seguro y generar parches que conserven la lógica empresarial original tanto como sea posible.
Esto significa que la misma capacidad puede usarse para escaneo de vulnerabilidades y también puede usarse para ataques. Como resultado, OpenAI ha reforzado las restricciones de la versión pública para tareas de ciberseguridad de alto riesgo.
Para los investigadores de seguridad que necesitan realizar pruebas de vulnerabilidad, estas restricciones también afectarán parte del trabajo normal. OpenAI está abriendo actualmente capacidades relacionadas de forma escalonada a través del proyecto Daybreak: los defensores pueden usar el GPT-6 Sol con menor tasa de rechazo a través de Daybreak Blue; los equipos de red teaming con autorización avanzada pueden llamar a la versión alfa de GPT-6 Astra y GPT-6 Cyber en Daybreak Red. OpenAI ha declarado que la serie GPT-6.2 también se introducirá en este sistema en el futuro.
Además, OpenAI ha incorporado señales de entrenamiento orientadas a la defensa durante la fase de entrenamiento. Anteriormente, se había utilizado IA para descubrir vulnerabilidades de alto riesgo como PHP2Shell. La serie GPT-6.2 mejora aún más la capacidad de identificar fallos de seguridad desde el origen del desarrollo y aprende a generar parches que equilibran la seguridad y la integridad funcional.
Este contenido se proporciona únicamente con fines informativos y educativos y no constituye asesoramiento de inversión relacionado con BTCC. BTCC realiza todos los esfuerzos posibles, pero no puede garantizar la veracidad, exactitud u originalidad del contenido anterior.