Informe de SemiAnalysis: ¿Por qué reducen las previsiones de demanda de chips y recortan drásticamente los ingresos de Nvidia?
 BlockbeatsAutor: SemiAnalysis
Título original: Revising Down Accelerator Demand and Shipment Outlook; NvidiaBears the Brunt
Autores originales: Myron Xie e Ivan Chiam
Nota del editor: Una Nvidia Feynman Ultra, en los dos modelos de SemiAnalysis, tiene un precio medio de venta que difiere en unos 77.000 dólares. El 13 de noviembre, esta firma de investigación de semiconductores redujo la previsión del precio medio de venta de este chip de unos 175.000 dólares a 98.000 dólares, una caída de aproximadamente el 44%. La bajada de los costes de la memoria de alto ancho de banda (HBM) explica parte de ello, y el resto del ajuste refleja el nuevo juicio de los analistas sobre la capacidad de fijación de precios de Nvidia. A medida que los grandes clientes disponen de más alternativas, la prima que Nvidia puede cobrar por sus chips de próxima generación podría ser inferior a lo previsto anteriormente.
Este ajuste va mucho más allá de Nvidia. SemiAnalysis ha reducido su previsión de gasto mundial en aceleradores de IA para 2028 de 1,054 billones de dólares a 758.000 millones de dólares, casi 300.000 millones menos. Según el nuevo modelo, en 2030 el gasto anual seguirá superando los 900.000 millones de dólares, más del doble que en 2026. El incremento sigue siendo considerable, pero el nuevo ingreso recurrente anualizado neto de los laboratorios de IA de vanguardia se ralentizó en el tercer trimestre, y los inversores también han endurecido la financiación de los centros de datos. Los proyectos que carecen de compromisos de compra de grandes clientes a menudo tienen que resolver primero quién financia la construcción de las instalaciones, la conexión eléctrica y la compra de equipos, para que los pedidos de chips puedan materializarse.
La presión sobre Nvidia proviene de dos tipos de clientes. Anthropic puede distribuir su capacidad de cómputo entre las TPU de Google, las Trainium de Amazon y dos fabricantes de GPU. OpenAI está impulsando sus propios chips y también puede obtener beneficios potenciales de la operación de warrants con AMD. Al mismo tiempo, Nvidia tiene la mayor exposición a los proveedores de nube emergentes entre todos los proveedores de chips. Estos clientes necesitan financiación para comprar las GPU y luego recuperar la inversión alquilando capacidad de cómputo. Los compradores de primer nivel tienen más opciones, y los que dependen de la financiación para expandirse tienen más dificultades para hacer pedidos. Con estas dos presiones combinadas, SemiAnalysis ha reducido en un 66% su previsión de ingresos por productos de cómputo correspondientes a los envíos de Nvidia en 2030.
La comparación entre Broadcom y MediaTek revela un aspecto que es fácil pasar por alto en esta competencia. Ambas participan en proyectos de TPU. MediaTek puede ofrecer un coste de sistema más bajo, pero Broadcom tiene la capacidad de respaldar la financiación de terrenos, electricidad, instalaciones y equipos. Para los compradores con problemas de liquidez, el coste total de un sistema y el efectivo que hay que desembolsar hoy son dos umbrales de compra diferentes. Cuando la competencia de chips se extiende a todo el centro de datos, los proveedores que pueden ayudar a los clientes a poner en marcha sus proyectos también tienen más posibilidades de conseguir pedidos.
A continuación, el texto original:
Resumen ejecutivo
· SemiAnalysis reduce su previsión de gasto en aceleradores para 2028 de 1,054 billones de dólares a 758.000 millones de dólares, y la previsión para 2030 es aproximadamente un 40% inferior a la versión anterior.
· El nuevo ingreso recurrente anualizado neto de los laboratorios de IA de vanguardia se ralentizó en el tercer trimestre, y los inversores de deuda y de capital también han endurecido la financiación de la infraestructura de IA; los proyectos sin compromisos de compra de grandes proveedores de nube son especialmente vulnerables.
· La revisión a la baja de los supuestos de precios de la memoria de alto ancho de banda (HBM) es una de las principales razones de la caída de las expectativas de gasto en aceleradores. En el nuevo modelo, la demanda de HBM medida en bits sigue creciendo año tras año.
· Los supuestos de volumen y precio de Nvidia se reducen ambos. Medidos por los ingresos de productos de cómputo correspondientes a los envíos, las previsiones para 2027 a 2030 se reducen un 22%, 39%, 56% y 66%, respectivamente.
· La previsión de ingresos acumulados de chips personalizados de Broadcom para 2026-2030 se reduce un 11%, principalmente por la bajada de precios de HBM. La previsión de envíos de ciclo de vida completo del Triggerfish de MediaTek diseñado para Anthropic se reduce un 42%.
· Las previsiones de gasto a largo plazo de AMD también se revisan a la baja, pero la operación de warrants refuerza su atractivo para Meta y OpenAI. Las previsiones de envíos de Trainium de Amazon para 2027 y 2028 se mantienen sin cambios.
Ajuste de las previsiones de demanda
Hemos reducido las previsiones de envíos, gasto y demanda eléctrica de chips y servidores de IA durante todo el periodo de previsión, con un mayor impacto en 2028-2030. Esta reducción refleja tres ajustes: menores envíos, menores precios y supuestos de menor consumo por chip para los futuros proyectos de aceleradores en 2029 y 2030.
En general, las razones de nuestro ajuste son las siguientes.
1. Hemos reevaluado las expectativas de ingresos totales por tokens de todo el ecosistema, teniendo en cuenta especialmente la ralentización del nuevo ingreso recurrente anualizado neto (ARR) de los laboratorios de IA de vanguardia en el tercer trimestre. Por ello, hemos reducido nuestras estimaciones de nueva oferta para que los ingresos puedan cubrir de forma más sostenible el coste total de cómputo, como señalamos en informes recientes. Seguimos siendo más optimistas que el consenso del mercado sobre los ingresos de estos laboratorios, y vemos muchas áreas donde se pueden desplegar capacidades de IA de vanguardia con un alto retorno de la inversión. Sin embargo, la financiación de la construcción de infraestructura depende de las expectativas generales de los participantes en los mercados de capitales, lo que nos lleva al siguiente punto.
2. Los mercados de capitales se han endurecido, y tanto los inversores de deuda como los de capital están menos dispuestos a financiar el gasto de capital relacionado con la infraestructura de IA, especialmente en proyectos sin compromisos de compra de hiperescaladores. Hemos tratado este tema en nuestro informe sobre el marco de financiación. Esto reducirá el desarrollo de terrenos, la infraestructura eléctrica y la construcción de edificios principales de los centros de datos; los proyectos afectados se concentrarán más en aquellos que carecen de apoyo de hiperescaladores, y la electricidad disponible para desplegar sistemas también disminuirá.
3. Los resultados de las elecciones de mitad de mandato en Estados Unidos han provocado el retraso de 5,8 GW de capacidad de centros de datos estadounidenses que estaba previsto que entraran en servicio en la segunda mitad de 2027 y la primera mitad de 2028. Los retrasos adicionales por factores regulatorios también están reduciendo la capacidad total de centros de datos en 2028. Hemos tenido en cuenta este factor en nuestro análisis, y efectivamente ha provocado una reducción de los envíos de equipos de cómputo a corto plazo, pero subrayamos que los dos factores anteriores son más importantes.
La magnitud de la reducción no es uniforme entre plataformas de chips y proveedores. Según nuestro marco analítico, los clientes seguirán priorizando los chips con mejor rendimiento por unidad de coste total de propiedad (perf/TCO) y por unidad de potencia (perf/W), y sobre esa base considerarán las condiciones de financiación. Las plataformas peor clasificadas en estas métricas sufrirán recortes mayores. Como resultado, Nvidia es la más afectada, y la mayor parte de los recortes de gasto se concentran en Nvidia. Además, entre los proyectos ASIC, esperamos que el proyecto de TPU de MediaTek también se vea afectado, porque su capacidad de financiación es más débil que la de Broadcom. El siguiente gráfico resume los cambios en el gasto total relacionado con aceleradores y HBM.
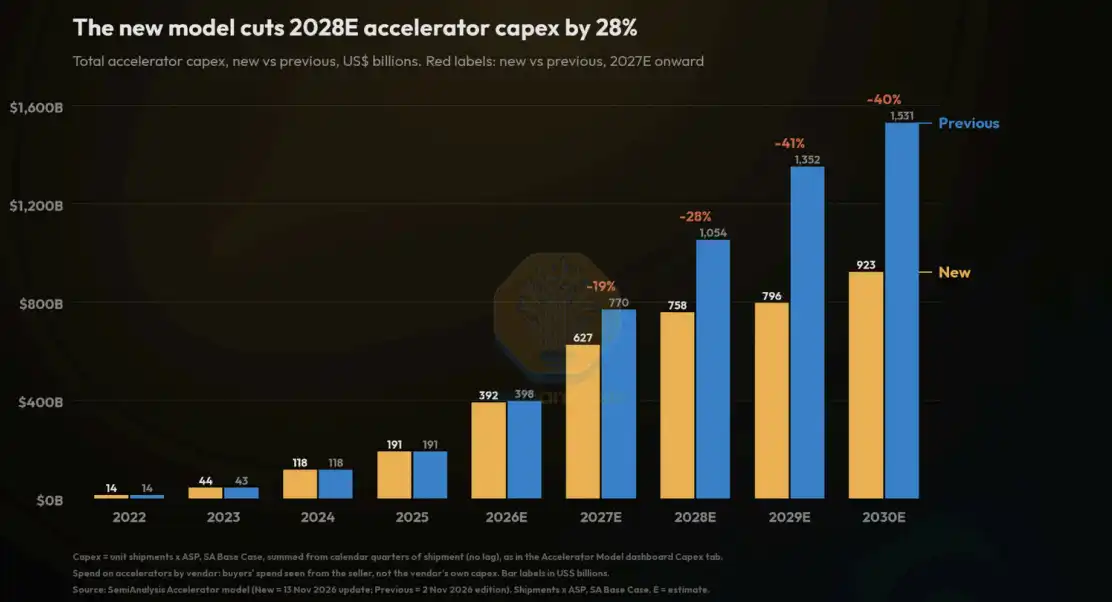
El nuevo modelo reduce la previsión de gasto de capital en aceleradores para 2028 en un 28%. Gasto de capital total en aceleradores, comparación entre el modelo nuevo y el antiguo, en miles de millones de dólares. A partir de la previsión de 2027, los números en rojo indican el cambio del nuevo modelo respecto al antiguo. Amarillo: versión nueva; azul: versión antigua.
La caída del gasto total está impulsada principalmente por los precios más bajos. Con la reducción de las previsiones de envíos, la relación entre oferta y demanda de HBM está más equilibrada, por lo que también hemos reducido los supuestos de precios de HBM. Para más detalles, véase la actualización del modelo de memoria publicada simultáneamente. Por ello, hemos incorporado los cambios de precios de HBM en las previsiones de cada chip para reflejar los cambios en el coste de la lista de materiales (BOM). Para los futuros productos de Nvidia a partir de Feynman, la reducción del precio medio de venta (ASP) también refleja márgenes de beneficio más bajos y cambios en el coste de HBM. Esto refleja que la competencia en el mercado de hardware de IA se ha intensificado significativamente.
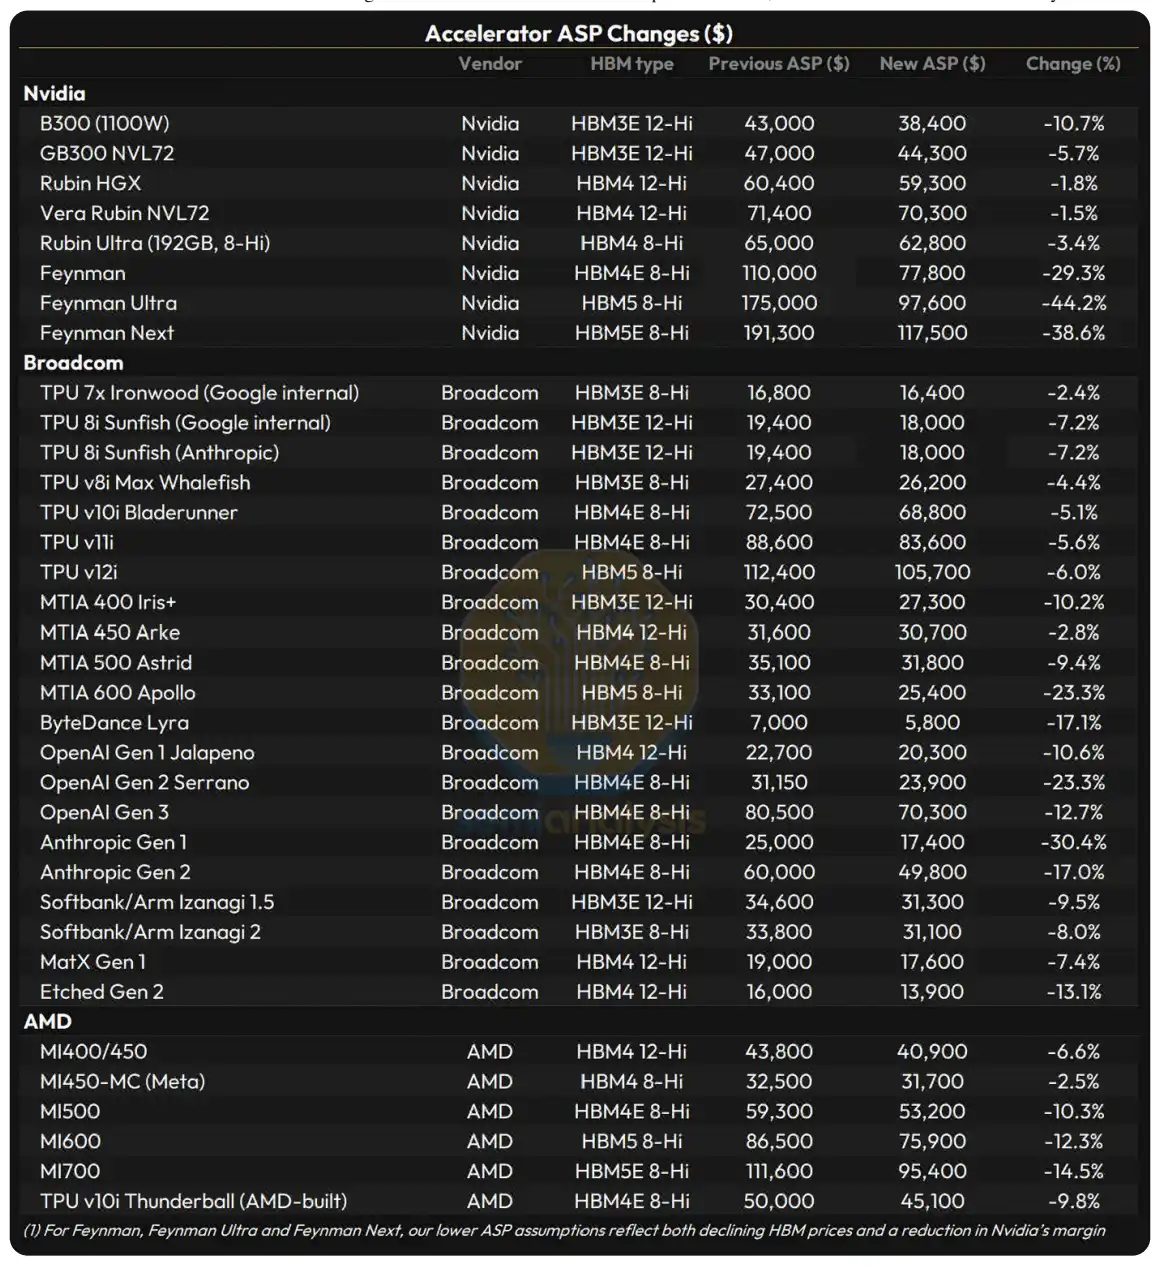
Ajuste del precio medio de venta (ASP) de aceleradores, en dólares. Modelo de producto, proveedor, tipo de HBM, ASP del modelo antiguo, ASP del modelo nuevo, variación (%). Fuente: SemiAnalysis.
Una parte considerable del incremento de gasto previsto anteriormente para 2027 procedía de subidas de precios, especialmente de la memoria. Por tanto, la posterior caída de precios significa que la cadena de suministro vuelve a un estado más «normal».
Los cambios de precios también explican por qué la superficie de silicio correspondiente a los envíos y la demanda de HBM medida en bits siguen aumentando, y crecen más rápido que el gasto nominal.
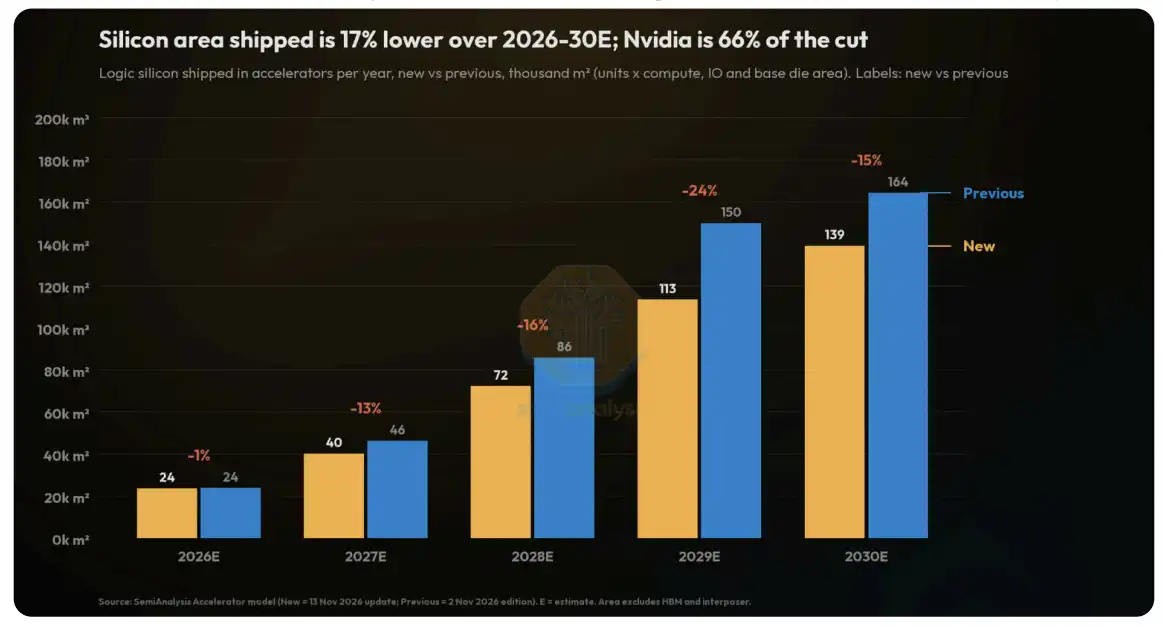
La superficie de silicio total prevista para envíos en 2026-2030 se reduce un 17%; Nvidia representa el 66% de la reducción.
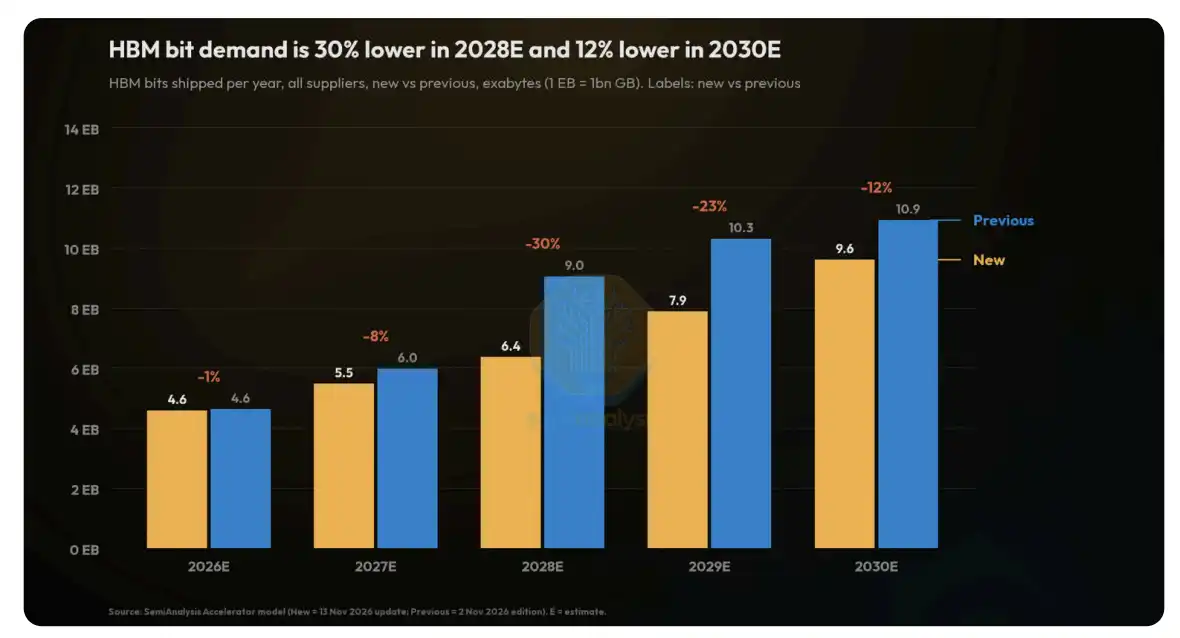
La previsión de demanda de bits de HBM para 2028 se reduce un 30%, y para 2030 un 12%.
La previsión de demanda eléctrica de IA también se ha reducido. Es el resultado conjunto de menores envíos y supuestos de menor consumo por chip. Dado que la electricidad sigue siendo un factor limitante, esperamos que las futuras hojas de ruta de productos reduzcan el consumo máximo de los chips. La caída de la demanda eléctrica también significa que, según nuestra previsión revisada de suministro eléctrico mundial (excluida China) para 2027-2029 en nuestro modelo de centros de datos, estos equipos enviados tendrán suficiente electricidad para su despliegue.
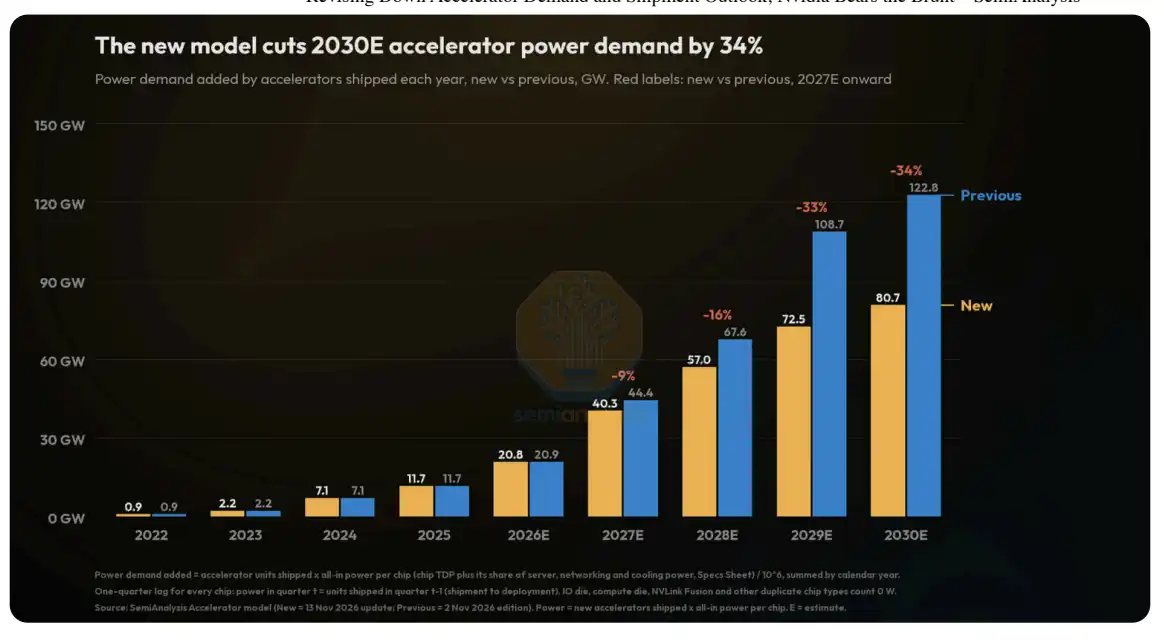
El nuevo modelo reduce la previsión de demanda eléctrica de aceleradores para 2030 en un 34%.
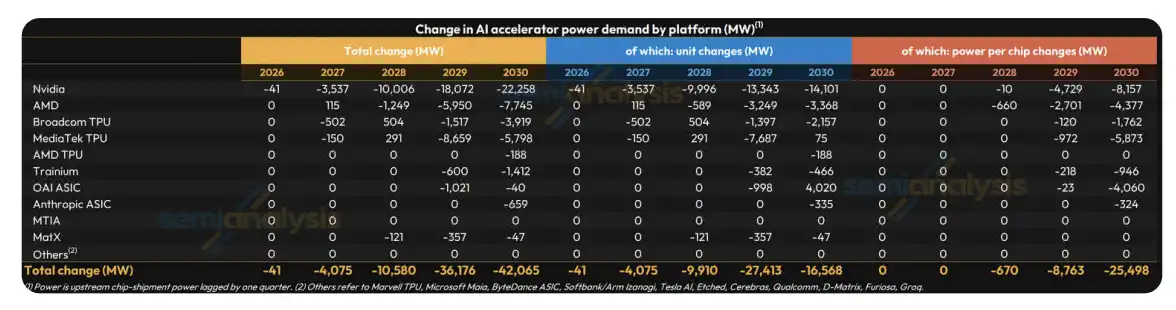
Cambios en la demanda eléctrica de aceleradores de IA por plataforma, en MW.
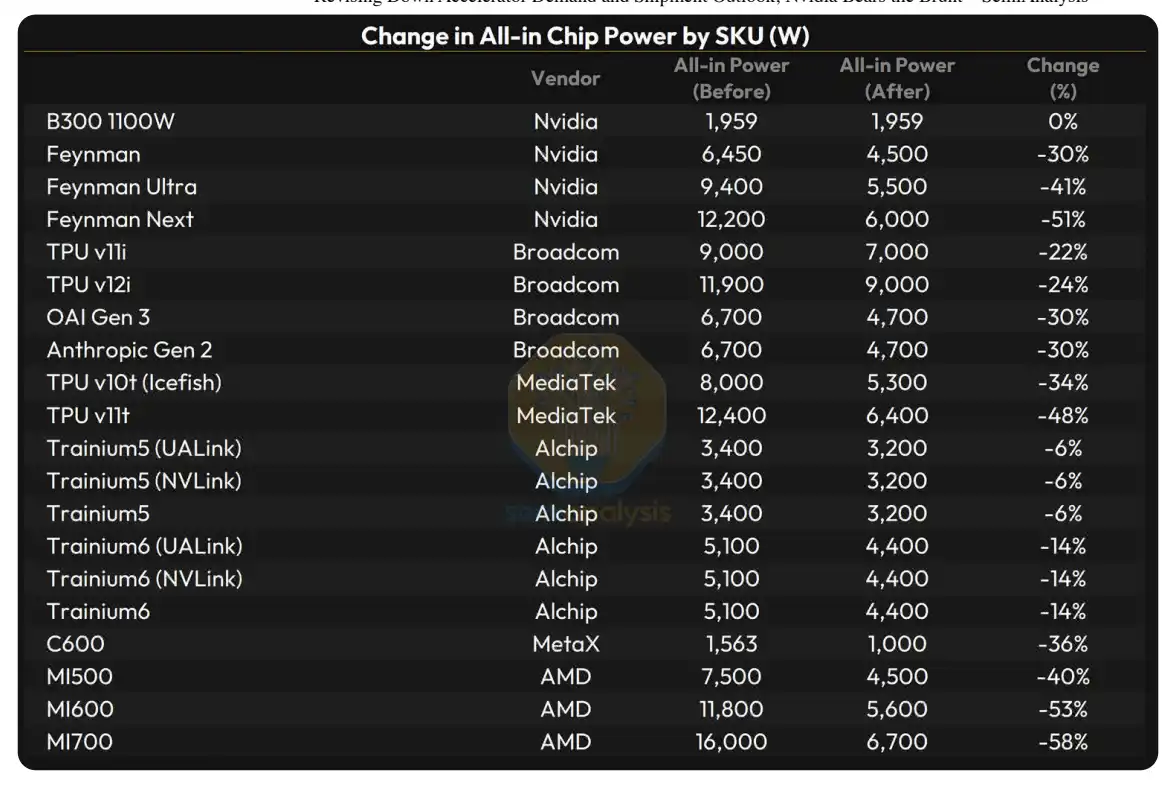
Cambios en el consumo combinado por modelo de chip, en W.
A continuación, repasaremos estos cambios por proveedor y plataforma.
Nvidia
Medidos por ingresos de productos de cómputo, hemos reducido drásticamente las previsiones de envíos de Nvidia para 2027, 2028, 2029 y 2030 en un 22%, 39%, 56% y 66%, respectivamente. Medidos por consumo combinado, las reducciones son del 14%, 35%, 50% y 59%. A partir de Feynman, además de incorporar los cambios en el coste de HBM, hemos reducido aún más los supuestos de precio medio de venta, porque creemos que Nvidia necesita aceptar márgenes más bajos para mantener la competitividad frente a otros proyectos. El precio previsto de Feynman se reduce de unos 110.000 dólares a unos 78.000 dólares; Feynman Ultra, de unos 175.000 dólares a unos 98.000 dólares; y Feynman Next, de unos 191.000 dólares a unos 118.000 dólares. La reducción simultánea de precios y envíos implica una caída significativa de los ingresos previstos de Nvidia. La reducción afecta a GPU, LPU de Groq y CPU independientes.
Hemos aplicado la mayor reducción a la demanda de Nvidia porque, en el sistema de cómputo de los laboratorios de IA de vanguardia, el atractivo de las GPU de Nvidia ocupa un lugar bajo. Entre las cuatro plataformas de cómputo que utiliza Anthropic —TPU, Trainium, GPU de AMD y GPU de Nvidia—, la GPU de Nvidia es la más marginal. En términos de rendimiento por coste unitario, Anthropic prefiere otras plataformas.
Aunque las GPU desempeñan un papel más importante en la infraestructura de OpenAI, si se tienen en cuenta los considerables beneficios financieros de la operación de warrants con AMD, las GPU de AMD se han convertido en una opción muy atractiva. Además, OpenAI priorizará el despliegue de sus proyectos ASIC Jalapeno y la próxima generación Serrano, porque el rendimiento por coste total de propiedad unitario de estos chips ya está a la cabeza.
Además, Nvidia tiene la mayor exposición a clientes de proveedores de nube emergentes (Neocloud) entre todos los proveedores, especialmente a los clientes de cola larga de menor tamaño. Hoy en día, los proveedores de nube emergentes se enfrentan a riesgos mucho mayores tanto en la ejecución de proyectos como en la capacidad de financiación. La capacidad de cómputo que los clientes finales chinos se han comprometido a comprar a los proveedores de nube emergentes también es considerable. La probabilidad de que la ley RASA se convierta en ley parece estar aumentando. Una vez en vigor, el acceso remoto a GPU se considerará exportación, por lo que el acceso remoto de clientes chinos a GPU avanzadas constituiría una violación de los controles de exportación.
Por último, señalamos que este ajuste del modelo no tiene en cuenta el impacto de la dimisión de Jensen Huang como consejero delegado de Nvidia. Incluso si Huang siguiera siendo consejero delegado, habríamos hecho el mismo ajuste. Dada la importancia de Huang para Nvidia, creemos que esta transición de liderazgo aumentará el riesgo de pérdida de cuota de mercado, y la caída podría superar las previsiones que aquí presentamos.
Debido al retraso de los envíos de las placas Vera Rubin L6 del tercer al cuarto trimestre, también hemos ajustado las previsiones para el tercer y cuarto trimestre de 2026. Hemos trasladado unas 100.000 GPU Rubin del tercer trimestre de 2026 al cuarto, manteniendo el envío anual de Vera Rubin en 2026 en unas 980.000 unidades. Las GB300 aumentan en unas 130.000 unidades en el tercer trimestre para cubrir este hueco. Con la aceleración de la producción de Rubin, en nuestra previsión del cuarto trimestre de 2026 hemos reducido unas 260.000 GB300 y unas 150.000 H200. Con todos estos ajustes, los ingresos totales de Nvidia en el tercer trimestre de 2026 serían de unos 109.100 millones de dólares, y en el cuarto, de unos 125.300 millones.
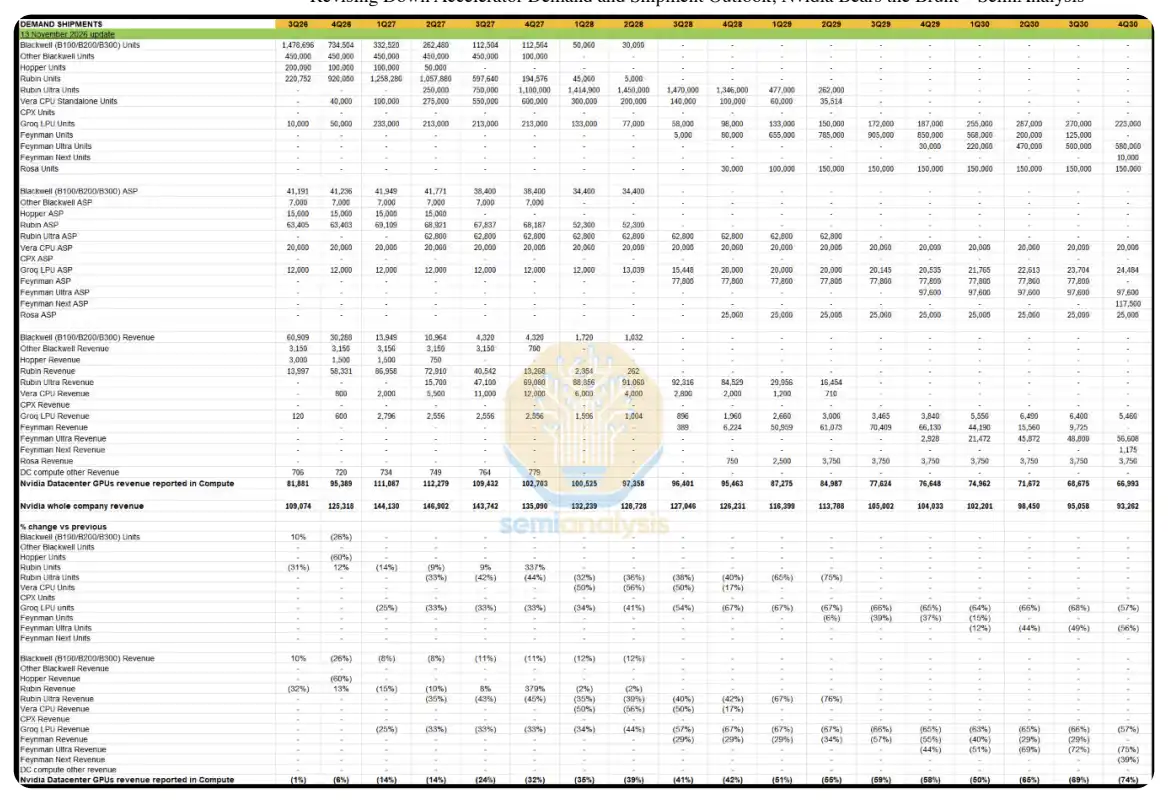
Previsión de envíos (Nvidia). La tabla, actualizada a 13 de noviembre de 2026, muestra por trimestre los envíos, el precio medio de venta y los ingresos de cada modelo, así como el porcentaje de variación respecto a la versión anterior. Las partidas agregadas incluyen los ingresos por GPU de centros de datos de Nvidia atribuidos al negocio de cómputo y los ingresos totales de Nvidia. Fuente: SemiAnalysis.
Broadcom
Broadcom es la menos afectada: la previsión de ingresos acumulados de ASIC para 2026-2030 se reduce un 11%, principalmente por la reducción del precio medio de venta derivada del menor coste de HBM, con un impacto menor de los recortes de envíos. Creemos que la demanda de Broadcom no caerá, porque sus tres grandes proyectos ASIC (TPU, OpenAI y Anthropic) ofrecen a los clientes finales un mayor rendimiento por coste unitario y por vatio, y Broadcom también tiene capacidad para respaldar los acuerdos de financiación de los acreedores, recaudando fondos para terrenos, electricidad, edificios principales y sistemas. En el caso de OpenAI, hemos reducido en 1 GW la previsión de escala del Serrano de segunda generación en 2029, al tiempo que aumentamos considerablemente los envíos del producto de tercera generación en 2030.
Hemos reducido ligeramente los envíos de TPU, que afectan a Google y Anthropic. Debido a la previsión de pausa en el desarrollo de centros de datos en Texas, también hemos retrasado de 2027 a 2028 la entrega de 700 MW de TPU prevista para Anthropic. Nuestro equipo de centros de datos espera que unos 275 MW de capacidad del proyecto Crusoe/Goodnight se retrasen desde el cuarto trimestre de 2027, y que otros 330 MW del proyecto Nexus en Hubbard, aún sin aprobar, también estén en riesgo. Ambos proyectos se destinan al despliegue de TPU de Anthropic.
Otro proyecto de Broadcom cuya previsión hemos reducido procede de la startup MatX. Creemos que MatX tiene mayor incertidumbre y más dificultades para obtener financiación, por lo que reducimos la estimación de demanda de chips de MatX por parte de Anthropic.
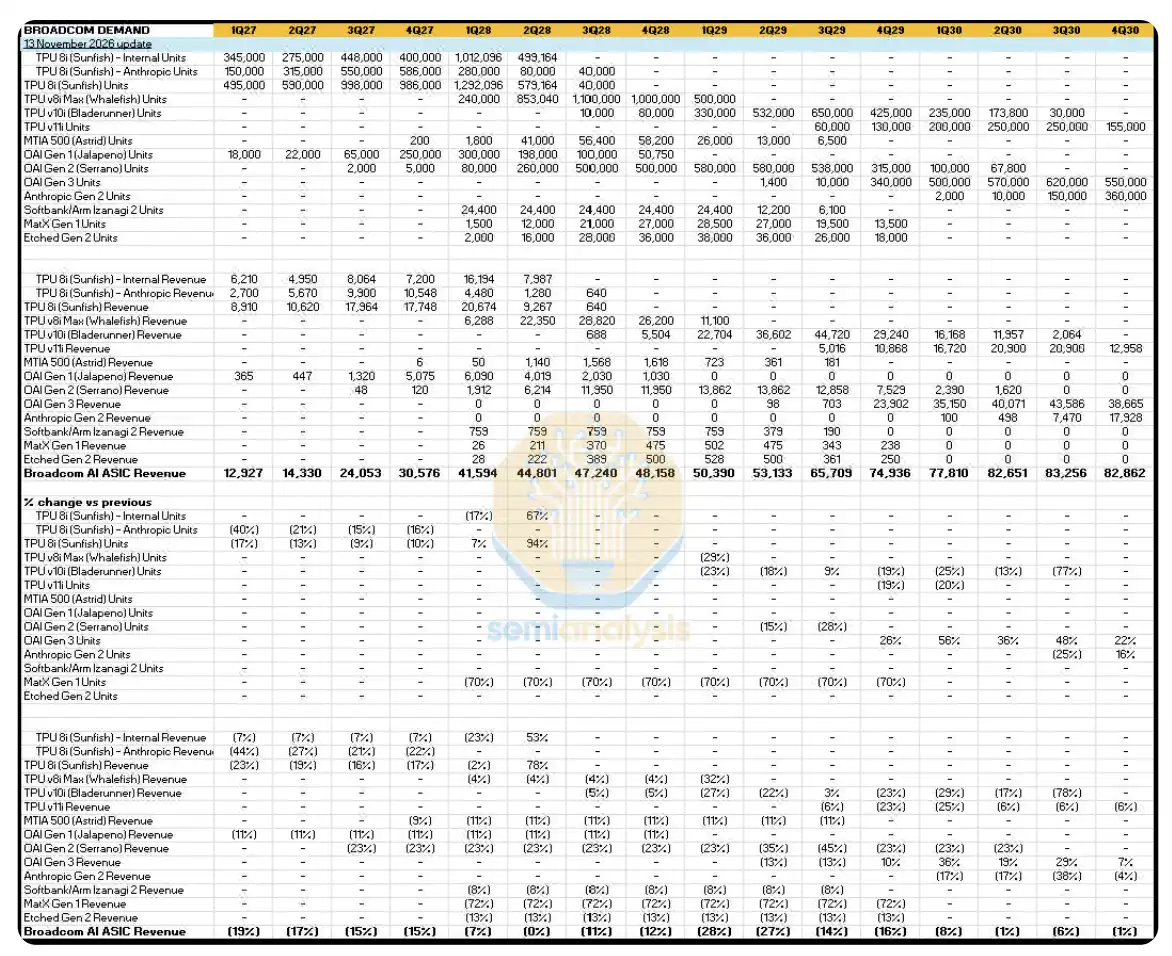
Demanda de Broadcom. La tabla, actualizada a 13 de noviembre de 2026, muestra por trimestre los envíos, ingresos y porcentaje de variación respecto a la versión anterior de los proyectos TPU, OpenAI, Anthropic y otros. La partida agregada es el ingreso por ASIC de IA de Broadcom. Fuente: SemiAnalysis.
MediaTek
Hemos aplicado una reducción mayor a los envíos de MediaTek.
Esto refleja tanto la caída de la demanda de Anthropic por factores de financiación como nuestro reajuste de la demanda total de TPU, ya que según nuestro modelo MediaTek asumirá la mayor parte de los envíos de TPU en el futuro, especialmente las TPU de uso interno de Google. Incluso después de esta reducción, los envíos de TPU de MediaTek en 2029-2030 siguen siendo superiores a los de otros socios como Broadcom y AMD/Marvell. Además, dado que los clientes de MediaTek compran la HBM por su cuenta, la bajada de precios de HBM no afecta a MediaTek, por lo que el cambio en la previsión de ingresos procede enteramente de la reducción de envíos.
La reducción se concentra en los dos productos de TPU v9, Humufish y Triggerfish. Hemos reducido los envíos de ciclo de vida completo de Humufish en 2028 y 2029 en un total de 470.000 unidades, lo que refleja principalmente que el rendimiento de EMIB-T sigue presentando riesgos.
Dado que las restricciones de financiación son una de las principales razones de este ajuste, creemos que la capacidad de Broadcom para ofrecer apoyo financiero a todo el proyecto de construcción es más importante para Anthropic. Por ello, el proyecto con mayor reducción es el TPU v9i (Triggerfish), cuyos envíos de ciclo de vida completo se reducen un 42%. Triggerfish se diseñó con aportaciones de Anthropic y estaba previsto que fuera el primer TPU de MediaTek vendido externamente a Anthropic.
No obstante, también reconocemos que el margen global de MediaTek es inferior al de Broadcom, por lo que el coste total del sistema es menor, lo que resulta atractivo cuando el capital es limitado. Esto requiere que Google asuma más responsabilidad de financiación o que Anthropic aumente los pagos anticipados.
Para el posterior TPU v10t (Icefish), hemos ralentizado el ritmo de aumento de producción en 2029 y trasladado más envíos a 2030.
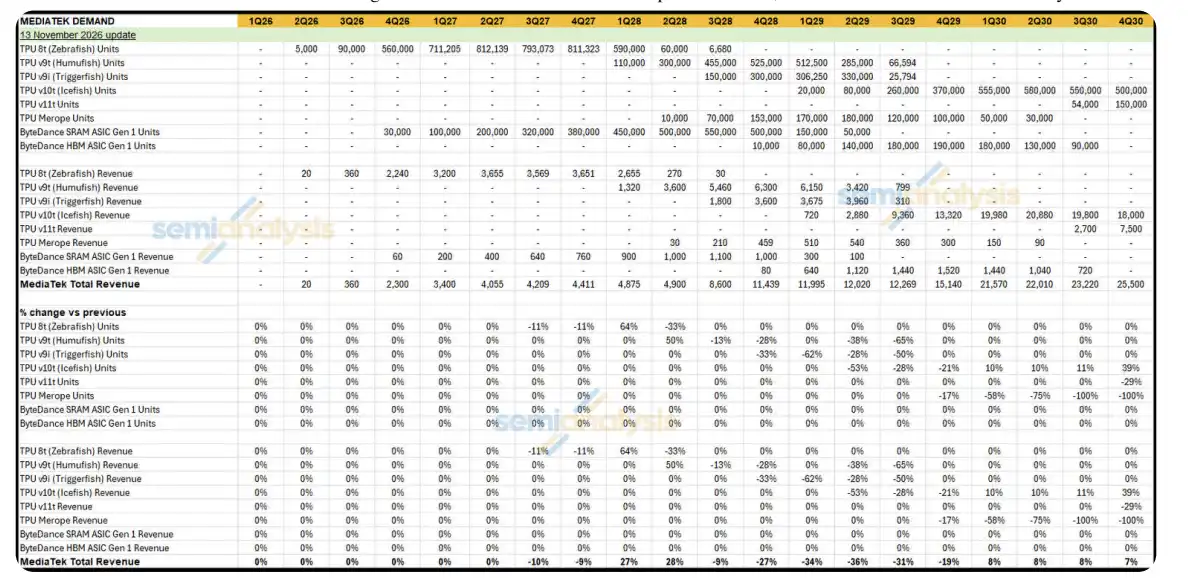
Demanda de MediaTek. La tabla, actualizada a 13 de noviembre de 2026, muestra por trimestre los envíos, ingresos y porcentaje de variación respecto a la versión anterior de cada modelo de TPU y del proyecto ASIC de ByteDance. La partida agregada es el ingreso total de MediaTek. Fuente: SemiAnalysis.
AMD
Medidas por consumo combinado, hemos reducido las previsiones de AMD para 2028, 2029 y 2030 en un 23%, 55% y 57%, respectivamente; por gasto, en un 29%, 35% y 32%. La previsión de consumo para 2027 se mantiene prácticamente sin cambios, y la de gasto se reduce un 11%. Aunque AMD también es un proveedor que vende chips comerciales en el mercado abierto, la reducción de ingresos es menor que la de Nvidia, porque AMD tiene mayor exposición a clientes hiperescaladores y laboratorios de IA de vanguardia, como Meta, OpenAI y Anthropic. Para Meta y OpenAI, la operación de warrants hace que la compra de sistemas AMD sea casi una decisión sin dudar. Anthropic no tiene operación de warrants, pero creemos que los precios de AMD siguen siendo muy favorables para Anthropic. En rendimiento por dólar en inferencia, el atractivo de AMD para Anthropic solo es superado por las TPU.
Además, a corto plazo, hemos adelantado el aumento de producción del MI400 para reflejar una rampa de producción más fuerte en el cuarto trimestre de 2026. Hemos trasladado unas 25.000 MI400 y unas 30.000 MI450-MC personalizadas para Meta del cuarto trimestre de 2027 al cuarto trimestre de 2026.
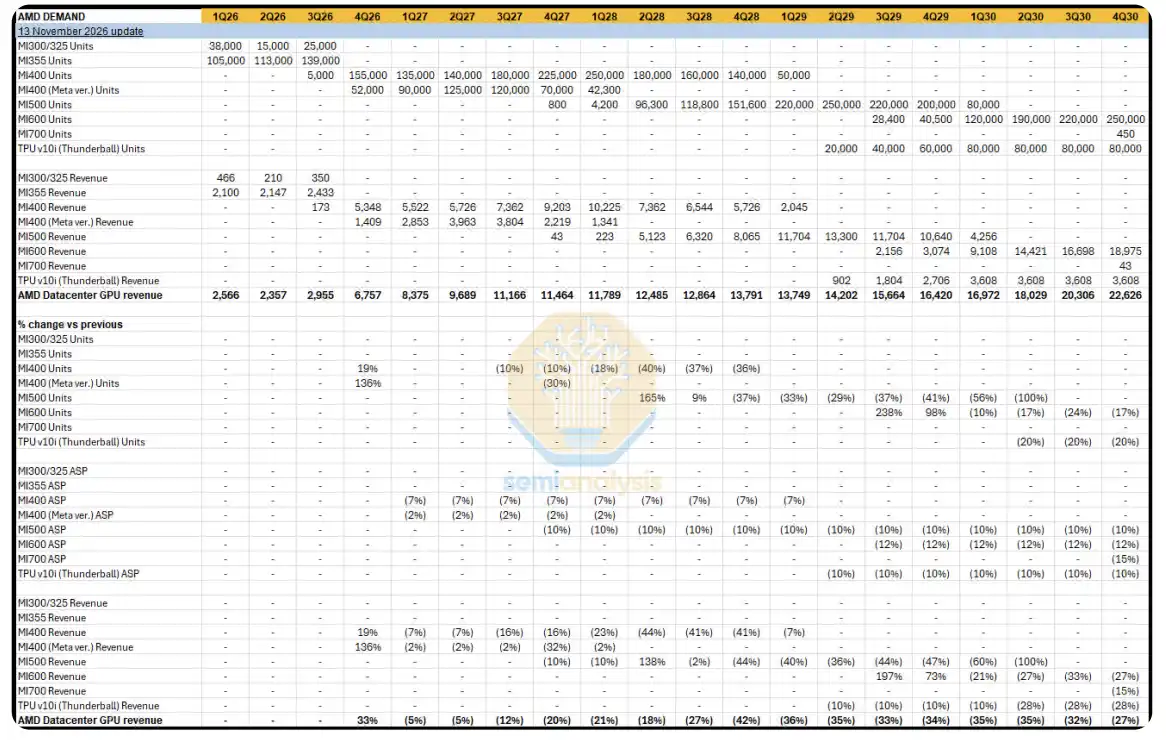
Demanda de AMD. La tabla, actualizada a 13 de noviembre de 2026, muestra por trimestre los envíos, ingresos y porcentaje de variación respecto a la versión anterior de cada modelo, e incluye el porcentaje de variación del precio medio de venta. La partida agregada es el ingreso por GPU de centros de datos de AMD. Fuente: SemiAnalysis.
Amazon Trainium
Mantenemos las previsiones de envíos de Trainium para 2027 y 2028. Para 2029, trasladamos los envíos previstos de Trainium4 a Trainium5, ampliamos el ciclo de vida de Trainium5 hasta 2030 y reducimos la escala de aumento de producción de Trainium6. Mantenemos las previsiones de envíos de Trainium a corto plazo porque la cartera de proyectos de centros de datos de Amazon en construcción y en preparación es muy amplia y en su mayoría no se ve afectada. Además, el coste de fabricación de Trainium es mucho menor, por lo que el coste para el cliente final también es bajo. Amazon también está dispuesta, por razones estratégicas, a subvencionar los proyectos de clientes clave como Anthropic y OpenAI que utilicen Trainium.
Otros ajustes
Hemos renombrado el TPU v9i (Whalefish) como TPU v8i Max (Whalefish).
Hemos renombrado «B300 1200W» como «B300 1100W» y actualizado en consecuencia el TDP. El consumo combinado del chip se mantiene sin cambios.
En el modelo ODM, hemos reducido en 200 unidades el pedido de racks Vera Rubin de Microsoft para 2027.
Este contenido se proporciona únicamente con fines informativos y educativos y no constituye asesoramiento de inversión relacionado con BTCC. BTCC realiza todos los esfuerzos posibles, pero no puede garantizar la veracidad, exactitud u originalidad del contenido anterior.