DeepSeek 並非完美,訓練過程存在“深度詛咒”

高性能大模型在訓練的過程中通常需要數千個GPU,耗費數月甚至更長時間才能完成一次訓練。 這種巨大的資源投入使得模型的每一層都必須高效訓練,才能確保算力資源最大化利用。
但大連理工、西湖大學、牛津大學等研究人員對Deepseek、Qwen、Llama和Mistral研究發現,這些模型的深層在訓練過程中表現並不好,甚至可以被完全剪枝而不會影響模型 性能。
例如,研究人員對DeepSeek-7B模型進行了逐層剪枝,以評估每一層對模型整體性能的貢獻。 結果顯示,。 這表明DeepSeek模型的深層在訓練過程中未能有效學習到有用的特徵,而淺層則承擔了大部分的特徵提取任務。
這種現象稱為“深度詛咒”(Curse of Depth),同時研究人員也提出了一種有效的解決方法——LayerNorm Scaling(層歸一化縮放)。
“深度詛咒”現象的根源在於Pre-LN的特性。 Pre-LN是一種在Transformer架構模型中廣泛使用的歸一化技術,它在每一層的輸入上進行歸一化,而不是在輸出上。 這種歸一化方式雖然能夠穩定模型的訓練過程,但也帶來了一個嚴重的問題,隨著模型深度的增加,Pre-LN的輸出方差會呈指數級增長。
。 換句話說,深層在訓練過程中變成了單位映射,無法學習到有用的特徵。
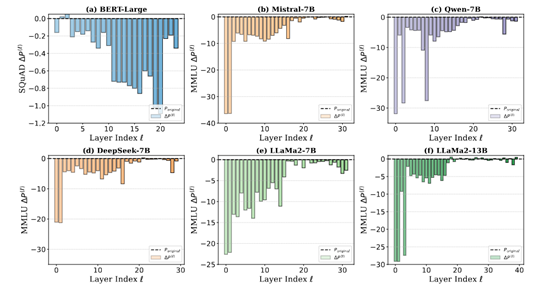
“深度詛咒”的存在對大語言模型的訓練和優化帶來了嚴重的挑戰。 首先,深層的訓練不足導致了資源的浪費。 在訓練大語言模型時,通常需要大量的計算資源和時間。 由於深層未能有效學習到有用的特徵,算力資源在很大程度上被浪費了。
深層的無效性限制了模型性能的進一步提升。 儘管淺層能夠承擔大部分的特徵提取任務,但深層的無效性使得模型無法充分利用其深度優勢。
此外,“深度詛咒”還對模型的可擴展性帶來了難題。 隨著模型規模的增加,深層的無效性愈發突出,這使得模型的訓練和優化變得更加困難。 例如,在訓練超大型模型時,深層的訓練不足可能導致模型的收斂速度變慢,甚至無法收斂。
LayerNorm Scaling 的核心思想是對Pre-LN輸出方差的精準控制。 在一個多層的 Transformer 模型中,每一層的層歸一化輸出都會被乘以一個特定的縮放因子。 這個縮放因子與當前層的深度密切相關,是層深度平方根的倒數。
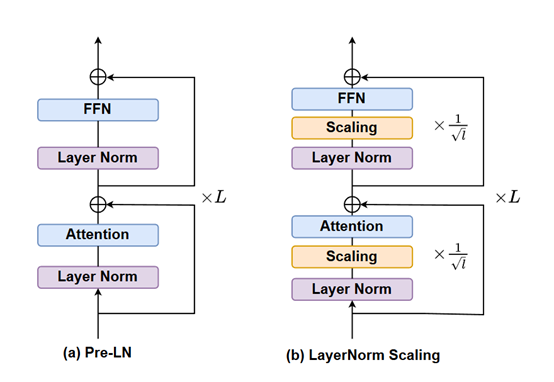
為大家舉個簡單易懂的例子,大模型就像一座高樓,每一層都是其中的一層樓,而 LayerNorm Scaling 就是給每一層樓的 “能量輸出” 進行了精細調節。
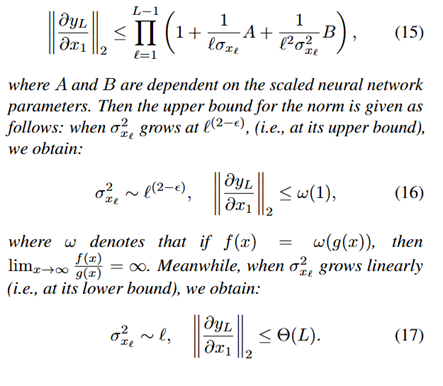
對於較低的樓層(淺層),縮放因子相對較大,這意味著它們的輸出被調整的幅度較小,能夠保持相對較強的“能量”;對於較高的樓層(深層) ,縮放因子較小,這樣就有效地降低了深層輸出的“能量強度”,避免了方差的過度積累。
通過這種方式,整個模型的輸出方差得到了有效控制,不會再出現深層方差爆炸的情況。 (整個計算過程比較複雜,有興趣的小伙伴可以直接看論文)
從模型訓練的視角來看,在傳統的 Pre-LN 模型訓練中,由於深層方差的不斷增大,梯度在反向傳播過程中會受到很大干擾。 深層的梯度信息變得不穩定,這就像在傳遞接力棒時,接力棒在後面幾棒的傳遞過程中總是掉落,導致信息傳遞不暢。
使得深層在訓練時難以學習到有效的特徵,模型的整體訓練效果大打折扣。 而 LayerNorm Scaling通過控制方差,穩定了梯度流。
在反向傳播過程中,梯度能夠更加順暢地從模型的輸出層傳遞到輸入層,每一層都能接收到準確而穩定的梯度信號,從而能夠更有效地進行參數更新和學習。
為了驗證LayerNorm Scaling的有效性,研究人員在不同規模的模型上進行了廣泛的實驗。 實驗涵蓋了從1.3億參數到10億參數的模型。
實驗結果顯示,。
例如,在LLaMA-130M模型上,LayerNorm Scaling將困惑度從26.73降低到25.76,而在10億參數的LLaMA-1B模型上,困惑度從17.02降低到15.71。 這些結果表明,LayerNorm Scaling不僅能夠有效控制深層的方差增長,還能夠顯著提升模型的訓練效率和性能。
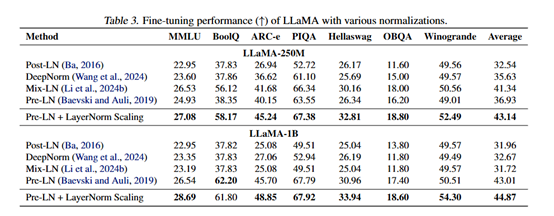
研究人員對LayerNorm Scaling在監督微調階段的表現進行了評估。 實驗結果顯示,LayerNorm Scaling在多個下游任務上均優於其他歸一化技術。
例如,在LLaMA-250M模型上,LayerNorm Scaling在ARC-e任務上的性能提升了3.56%,在所有任務上的平均性能提升了1.80%。 這表明,LayerNorm Scaling不僅在預訓練階段表現出色,在微調階段也能夠顯著提升模型的性能。
此外,研究人員將DeepSeek-7B模型的歸一化方法從傳統的Pre-LN替換為LayerNorm Scaling。 在整個訓練過程中,深層塊的學習能力得到了顯著提升,能夠積極地參與到模型的學習過程中,為模型的性能提升貢獻力量。 困惑度下降的幅度更為明顯,下降速度也更穩定。