從 Eliza 的 Github 倉庫,看 AI 框架的優缺點

作者:Reforge
編譯:深潮 TechFlow
框架概覽
資料截至 2025 年 1 月 12 日
最新版本/發布:v0.1.8+build.1(2025 年 1 月 12 日)
GitHub 倉庫:Eliza
授權協議:開源 MIT 授權
主要語言:TypeScript
-
統計數據:
11,200 個星標
3,100 分叉
366 位貢獻者
簡介
Eliza 是一個開源的智能體開發框架,旨在讓建構 AI 智能體變得更加簡單、強大且靈活。 它是否真的能達到宣傳的效果? 在這篇文章中,我們將深入探討 Eliza 的優點、局限性,以及在實際使用上需要注意的事項。
Eliza 的定位
框架目標:為開發個人化、多模態的 AI 智能體提供一站式工具,這些智能體能夠處理複雜的任務。
主要應用情境:包含 AI 助理、社群媒體角色、知識型工作者、互動虛擬角色等。
-
核心功能特性:
模組化運行時:支援註冊操作和插件,方便擴充功能。
跨平台部署:相容於 X(原 Twitter)、Discord、Telegram 等多種平台,支援廣泛的應用場景。
角色驅動客製化:透過詳細的角色檔案(如背景故事、知識庫、語調等)實現高度個人化的智能體。
多媒體處理能力:支援文字、影片、影像等多模態資料的處理。
推理功能:支援本地和雲端推理,使其適應不同的部署環境。
檢索增強生成 (RAG):透過外部資料來源和知識庫提供長期記憶和上下文感知能力。
從功能描述來看,Eliza 是一個多功能的智能體開發平台。 但在實際應用中,它的表現如何?
Eliza 的實際能力
-
角色客製化:Eliza 提供了強大的角色系統,允許使用者創建具有獨特語調、風格和背景故事的智能體。
這使得 Eliza 在建構敘事驅動的虛擬助理或保持一致品牌語調的場景中表現尤為出色。
使用者可以透過設定角色的個人簡介、背景故事、知識點和語調等屬性,靈活地調整智能體的個人化表現。
-
跨平台整合:Eliza 支援與 Discord、Slack、Telegram 等平台的無縫對接,使智能體能夠適應不同的社群互動需求。
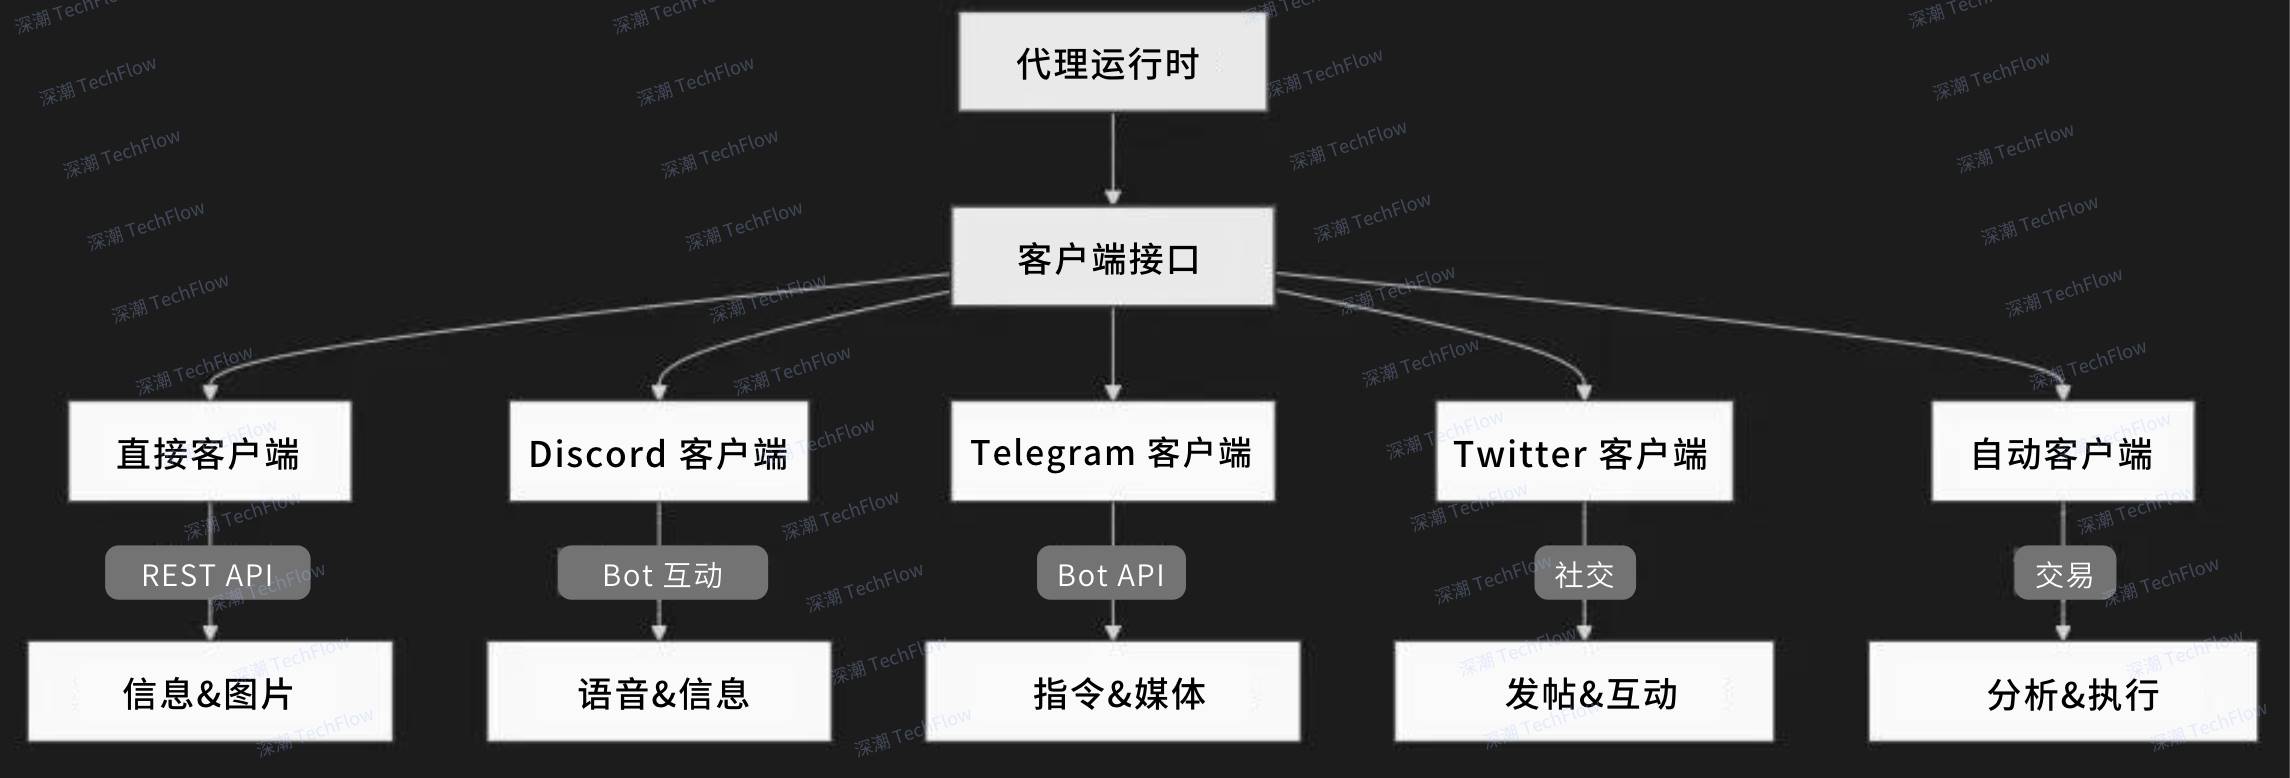
例如,社群媒體機器人和客戶服務智能體可以輕鬆實現跨平台部署,並協同工作以提高效率。
客戶端包架構概述(來源:Eliza Docs)。 原圖來自 Reforge,由深潮 TechFlow 編譯。
-
可擴展的插件系統:Eliza 提供了豐富的插件支持,用戶可以根據需求擴展功能,例如文字轉語音、圖像生成和區塊鏈數據檢索。
例如,在市場分析場景中,用戶可以透過外掛程式實現即時數據獲取,並產生高品質的評論或見解內容。
-
檢索增強生成 (RAG):此功能使得智能體能夠根據外部資料來源和知識庫產生更精準的答案。
例如,市場分析機器人可以透過整合外部文件和快取機制,提供上下文相關且快速的回應,從而提高服務品質。
可信任執行環境 (TEE) 支援:Eliza 提供了一層安全保護,讓智能 體處理敏感資料和工作流程,確保關鍵任務的安全性和可靠性。
Eliza 的不足之處
缺乏自適應學習
靜態角色配置:Eliza 的角色個性配置是預先定義的,無法根據使用者的即時互動或歷史對話動態調整。 這意味著智能體在長時間使用中可能顯得“千篇一律”,無法根據使用者需求做出改變。
無法從回饋中學習:目前,Eliza 並沒有機制從使用者的修正或回饋中學習,也無法根據先前的錯誤調整自身行為。 這種缺乏自適應學習的特性,會導致智能體一再犯下同樣的錯誤或提供不符合使用者期望的答案。
缺乏分層規劃能力
無子任務分解功能:Eliza 無法將複雜的高層目標分解為多個小任務。 例如,在需要進行多篇文獻研究並總結出多段內容的場景中,Eliza 會顯得力不從心。 分層規劃通常需要目標分解和子任務分配功能,而 Eliza 並未內建這些能力,開發者需要自行整合任務規劃庫來彌補這一不足。
智能體之間協作能力有限
缺乏協調機制:雖然 Eliza 支援多房間和多用戶的環境,但它並不具備智慧體之間的動態協作功能。 智能體無法分享上下文資訊、分配任務或解決衝突目標,這在需要多個智能體協同工作的場景中會顯得特別局限。
記憶功能與情境處理的限制
基礎的鍵值儲存:Eliza 的記憶系統僅能簡單地儲存數據,但無法優先處理最近或更相關的上下文資訊。 在長時間的對話中,智能體可能會忘記關鍵細節,導致對話缺乏連貫性。
缺乏記憶清理機制:Eliza 沒有內建的記憶清理功能,無法自動移除過時或不相關的資料。 這會導致記憶系統逐漸膨脹,不僅降低效能,還可能產生與情境無關的答案。
錯誤處理能力不足
基礎的API 錯誤處理:當外部服務發生故障時,Eliza 僅會傳回錯誤提示,而不會嘗試切換到 備用資料來源。 更完善的錯誤恢復機制,例如在服務失敗時切換到次級選項,將顯著提升系統的穩定性和使用者體驗。
缺乏真正的多模態智能
跨模態能力不足:雖然Eliza 支援一些多模態插件(如文字轉語音和圖像生成),但它無法將文字、圖像和音訊等多種輸入結合起來進行 統一分析和推理。 例如,Eliza 無法同時處理視覺資料和文字輸入,這限制了它在多模態場景中的應用潛力。
Eliza 最適合的應用場景
市場情報智能體:可以幫助企業追蹤使用者情緒趨勢、分析社群媒體上的討論熱點,並產生即時的自動化回應。 這類智能體特別適合需要快速反應的行銷或品牌管理工作。
內容產生機器人:在多個社群平台上產生一致的品牌化內容,例如定期發布的貼文或廣告訊息。 這些機器人能夠確保品牌語調的一致性,同時減少人工操作的工作量。
客戶支援機器人:基於整理好的知識庫,提供使用者快速、準確的回答,特別適合處理常見問題(FAQ)。 這些機器人不僅能夠根據情境提供腳本化的回應,還可以透過角色個人化設計,與品牌文化保持一致,提升使用者體驗。
總結
Eliza 提供了一個靈活且可擴展的框架,非常適合開發以角色為核心的智能體,尤其在簡單或腳本化的工作流程中表現出色。 它在創建跨平台一致性的虛擬角色方面具有明顯優勢,但由於缺乏學習能力和策略規劃功能,目前還不能稱為真正的自主智能體開發框架。
如果使用者的目標是建立能夠自適應環境、進行協作或處理複雜邏輯的智能體,開發團隊需要在 Eliza 的基礎上進行大量的二次開發。 這意味著,對於那些需要高效實用的應用場景,其核心價值更體現在客製化功能的開發,而非框架本身的原生能力。
要注意的是,

登入回覆
登入分享您的看法評論
相關文章
|Square
下載BTCC APP,您的加密之旅從這啟程
立即行動 掃描 加入我們的 100M+ 用戶行列