إطلاق GPT-6.2: قدرات جديدة ومعدل هلوسة 59%
 chaincatcher
بقلم: شياوجينغ
تحرير: شو تشينغيانغ
في 17 نوفمبر بالتوقيت المحلي للولايات المتحدة، أطلقت OpenAI رسميًا GPT-6.2 Astra وGPT-6.2 Sol.
جاء هذا الإطلاق متأخرًا عن المتوقع. ففي نهاية أكتوبر، اكتشف بعض المستخدمين آثارًا لنموذج يُشتبه أنه GPT-6.2 في سجلات استخدام ChatGPT، ومنذ ذلك الحين تسربت معرفات النموذج ولقطات اختبار باستمرار. وكانت وسائل الإعلام قد توقعت سابقًا إطلاق النموذج الجديد في 6 نوفمبر، لكن تاريخ الإطلاق النهائي جاء متأخرًا 11 يومًا عن هذا التوقع.
ركّزت OpenAI هذه المرة على قدرة الذكاء الاصطناعي على تولي الأعمال الاحترافية.
من نسخ عرض تقديمي كامل من لقطة شاشة لملف PPT، إلى استخراج البيانات المالية وبناء نماذج التقييم المالي، وتشغيل Blender لإنشاء نماذج ثلاثية الأبعاد للسيارات، ومحاكاة الحركة الفيزيائية لنظام تعليق المركبات، وحتى استخدام CAD لتصميم أجزاء ميكانيكية والتحقق من علاقات التجميع، بدأ GPT-6.2 في التعمق في مهام كانت تتطلب سابقًا محترفين لاستخدام برامج معقدة.
أبرزت OpenAI بشكل خاص أن النموذج الجديد يمكنه تقليل المخرجات غير الفعالة والتعديلات المتكررة، مما يجعل النتائج التي يقدمها الذكاء الاصطناعي أقرب إلى معايير العمل الاحترافي.
خلال الشهرين الماضيين، أطلقت OpenAI نماذج مثل GPT-6 Astra وSol وLuna، بالإضافة إلى GPT-6.1 Sol وTerra. ويُعد GPT-6.2 Astra الذي تم إطلاقه حديثًا ترقية للنموذج الرائد بعد GPT-6 Astra في سبتمبر، مع التركيز على تعزيز التعامل مع المهام الاحترافية المعقدة؛ بينما يعزز GPT-6.2 Sol بشكل أساسي كفاءة العمل اليومي والبرمجة ومهام الوكيل متعددة الخطوات.
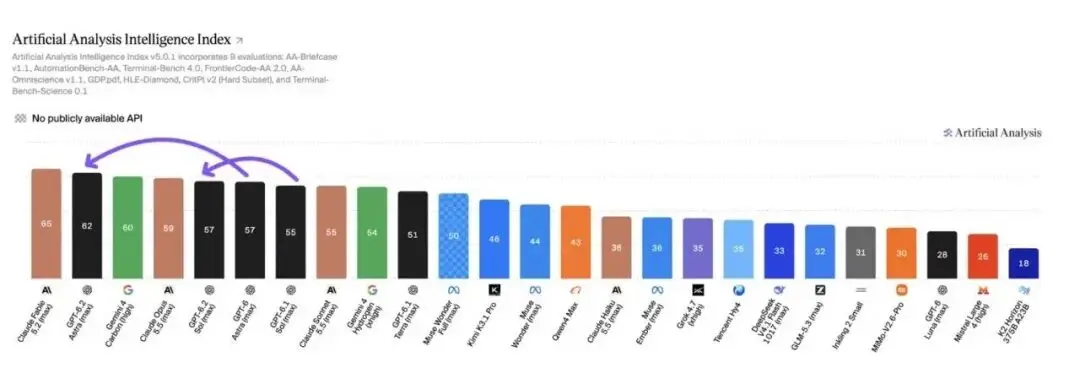
وفقًا لأحدث قائمة من Artificial Analysis، ارتفع Astra إلى المركز الثاني عالميًا بدرجة 62، بزيادة 5 نقاط عن الجيل السابق؛ وحقق Sol درجة 57. ومن حيث التسعير، انخفض سعر الوحدة لكل من الإدخال والإخراج لواجهة برمجة تطبيقات Astra بنسبة 20%، وانخفض سعر الإدخال المخزن مؤقتًا بنسبة 60%؛ وحافظ Sol على سعره الأصلي، لكن التكلفة الإجمالية لإنجاز مهام معينة انخفضت بشكل أكبر.
من الجدير بالذكر أن GPT-6.2 Astra هو أيضًا أول نموذج تم تقييمه علنًا من OpenAI يصل إلى عتبة القدرة العالية للتحسين الذاتي للذكاء الاصطناعي.
ومع ذلك، أثارت العروض والنتائج المبهرة آراء متباينة. ففي يوم الإطلاق، أعرب العديد من المطورين الذين اختبروا النموذج الجديد قبل أسابيع عن خيبة أملهم علنًا، معتقدين أن Astra قد يتوقف قبل الأوان أثناء مهام تطوير البرمجيات طويلة الأمد، وأن المخرجات المختصرة بشكل مفرط قد تفوت معلومات ضرورية في بعض الأحيان.
ومع اقتراب قدرات النموذج من العمل الاحترافي الحقيقي، برزت حدود قدراته وضوابط السلامة كأحد أبرز محاور هذا الإطلاق.
سام ألتمان، الرئيس التنفيذي لشركة OpenAI. صورة مولدة بالذكاء الاصطناعي
01 الأداء والتكلفة
سعر واجهة برمجة التطبيقات لـ GPT-6.2 Astra هو 8 دولارات لكل مليون توكن إدخال و40 دولارًا لكل مليون توكن إخراج، مع تسعير الإدخال المخزن مؤقتًا بـ 0.40 دولار. وبالمقارنة مع الجيل السابق، انخفضت أسعار الإدخال والإخراج بنسبة 20%، وانخفض الإدخال المخزن مؤقتًا من دولار واحد إلى 0.40 دولار، أي بانخفاض 60%. يحافظ GPT-6.2 Sol على سعر 2 دولار لكل مليون توكن إدخال و10 دولارات لكل مليون توكن إخراج.
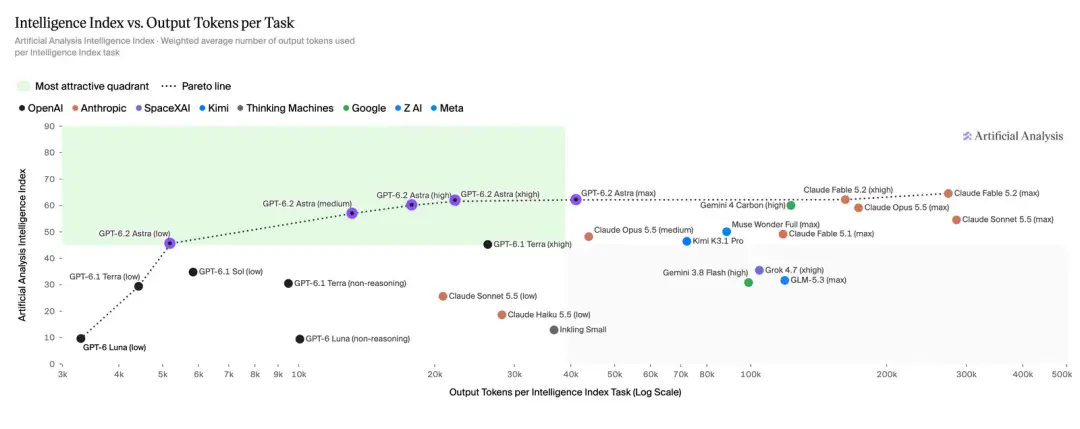
بالنسبة للوكلاء متعددي الخطوات، لا يعكس سعر وحدة واجهة برمجة التطبيقات النفقات الفعلية بالكامل. فعندما ينفذ النموذج المهام، قد يتطلب الأمر استدعاءات متعددة للأدوات، وقراءة الملفات، ومعالجة الأخطاء، وإعادة المحاولة. وحتى إذا ظل سعر الوحدة دون تغيير، إذا كانت هناك حاجة إلى عدد أقل من التوكنز لإكمال المهمة، فستنخفض الفاتورة النهائية وفقًا لذلك.
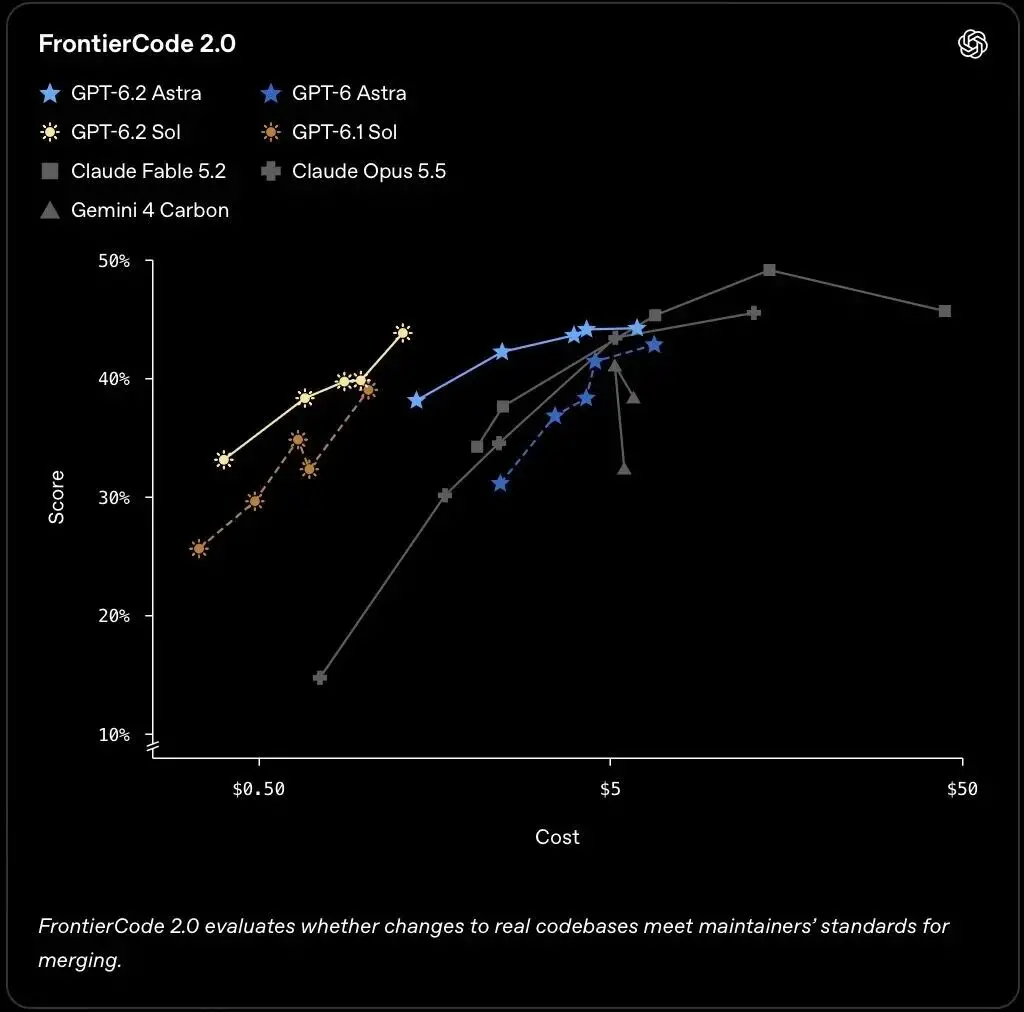
في اختبار البرمجة FrontierCode 2.0 من Cognition، سجل GPT-6.2 Sol أقل بـ 0.5 نقطة فقط من Astra، مع تكاليف تبلغ حوالي خمس تكلفة الأخير. وفي تقييم LifeVal الذي يستهدف المهام اليومية المعقدة، تجاوزت درجة Sol النموذج الرائد السابق GPT-6 Astra، مع تكلفة المهام الفردية حوالي سُبع تكلفة الأخير.
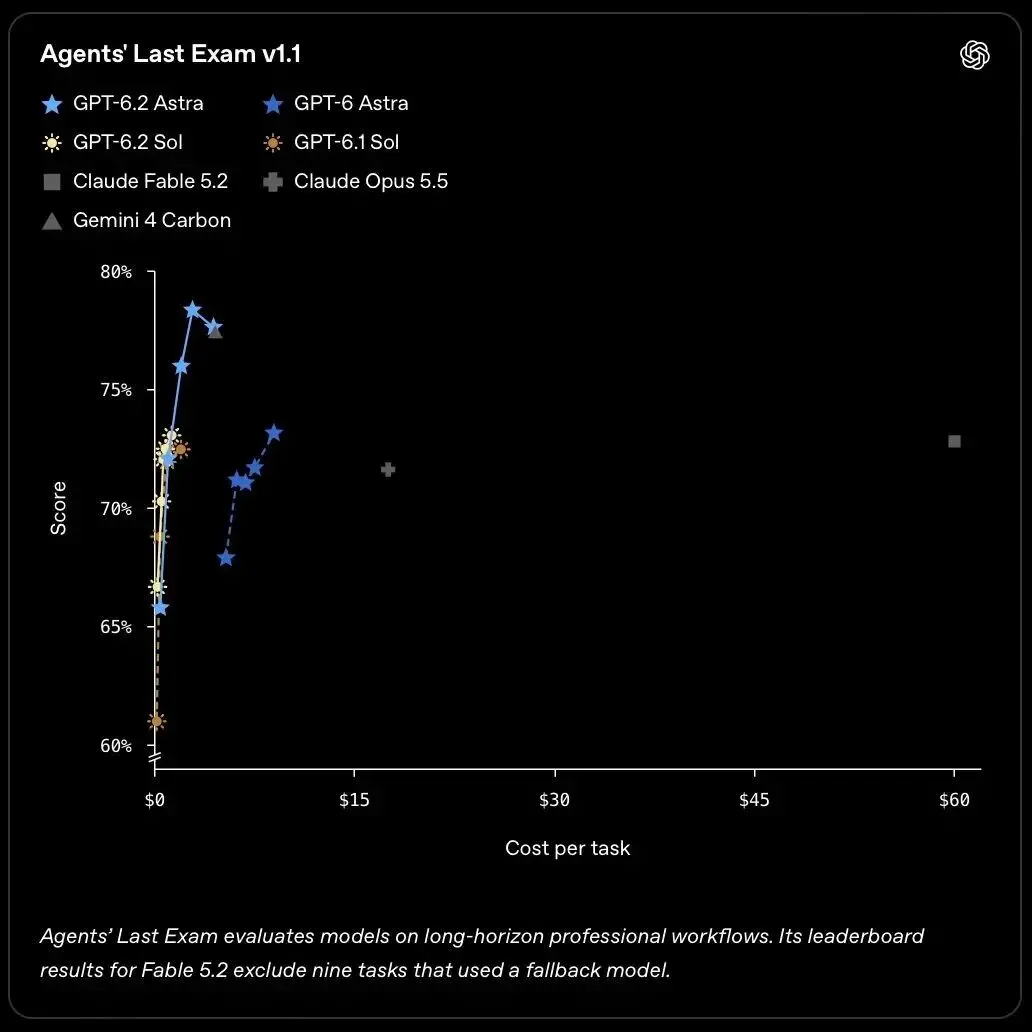
أظهر Astra أيضًا تحسنًا في المهام عالية الصعوبة. ففي تقييم Agents' Last Exam، تحسن بمقدار 5.2 نقطة مقارنة بـ GPT-6 Astra، مع تكلفة إنجاز المهام أقل من ثلث تكلفة الجيل السابق. وبالمقارنة مع Claude Fable 5.2، سجل Astra أعلى بـ 5.5 نقطة، مع تكلفة المهام الفردية حوالي 5% من تكلفة الأخير.
02 إنجاز الأعمال الاحترافية
تتطلب الأعمال الاحترافية في مجالات التمويل والقانون والاستشارات من الذكاء الاصطناعي التعامل مع كمية كبيرة من البيانات الأولية، والتحقق من المعلومات، وإنتاج مخرجات وفقًا لمعايير الصناعة. وذكرت OpenAI أن GPT-6.2 Astra قد تحسن في هذه المهام، وأصبح قادرًا على أداء النمذجة المالية، وتحليل الاندماج، والبحث القانوني، وتحليل علوم البيانات.
يغطي اختبار GDPval v2 الداخلي من OpenAI مجالات مثل الاستشارات والتمويل والتصميم، حيث تحسنت درجة Astra بمقدار 6.2 نقطة مئوية مقارنة بالجيل السابق، وانخفضت التوكنز المُخرجة بنسبة 22%.
في البحث القانوني، في اختبار Harvey LAB-AA v1.1 الذي يحاكي مهام مكاتب المحاماة الحقيقية، تجاوز معدل نجاح Astra معدل نجاح Claude Fable 5.2 بأكثر من الضعف، مع تكلفة المهام الفردية حوالي سدس تكلفة الأخير.
يغطي اختبار GDPval v2 الداخلي من OpenAI أيضًا أعمال الاستشارات والتمويل والتصميم. وأظهرت نتائج الاختبار أن درجة Astra تحسنت بمقدار 6.2 نقطة مئوية مقارنة بالجيل السابق، مع انخفاض التوكنز المُخرجة بنسبة 22%.
03 دخول العالم ثلاثي الأبعاد
قدرة أخرى أظهرها GPT-6.2 Astra هي المشاركة المباشرة في النمذجة ثلاثية الأبعاد والتصميم الهندسي. لم يعد النموذج يكتفي بتوليد كود النمذجة. بل يمكنه أيضًا تشغيل البرامج الاحترافية والتعامل مع الأجزاء وضبط الهياكل وإنشاء محتوى مرئي من النتائج الحسابية.
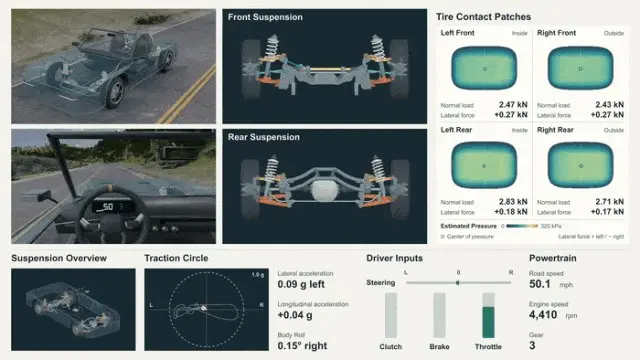
GPT-6.2 Astra يحاكي القيادة على الطرق الجبلية وديناميكيات الهيكل
في حالة محاكاة القيادة على الطرق الجبلية، أنشأ Astra أولاً نموذجًا ثلاثي الأبعاد لسيارة رياضية، ثم كتب حلالاً فيزيائيًا بلغة Python لحساب قوة الإطارات على الأرض والتغيرات الديناميكية في نظام التعليق، وأخيرًا استورد نتائج الحساب إلى Blender لإنشاء رسوم متحركة لقيادة المركبة. من خلال المحاكاة، يمكن للمهندسين ملاحظة حالات انتقال الحمل عندما تعبر المركبة ظروف طرق معقدة قبل تصنيع نموذج أولي مادي.
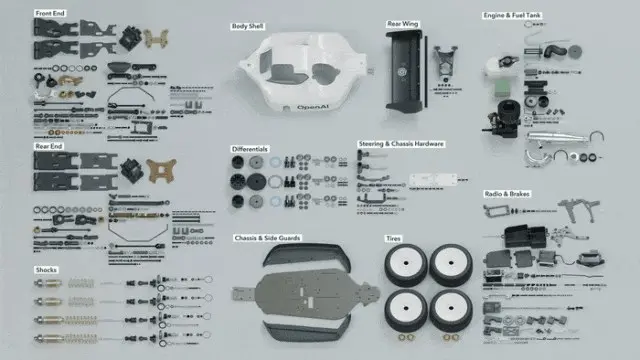
كانت بيانات الإدخال لحالة النمذجة الميكانيكية أبسط بكثير. قدمت OpenAI فقط صورًا عامة وأدلة تجميع لسيارة طرق وعرة يتم التحكم فيها عن بُعد بمقياس 1:8 ومحرك بست أسطوانات مستقيمة. وبناءً على ذلك، أنشأ Astra نماذج ثلاثية الأبعاد لأجزاء ميكانيكية مختلفة وأنتج رسومًا متحركة للتجميع خطوة بخطوة وكتالوجات أجزاء مصورة.
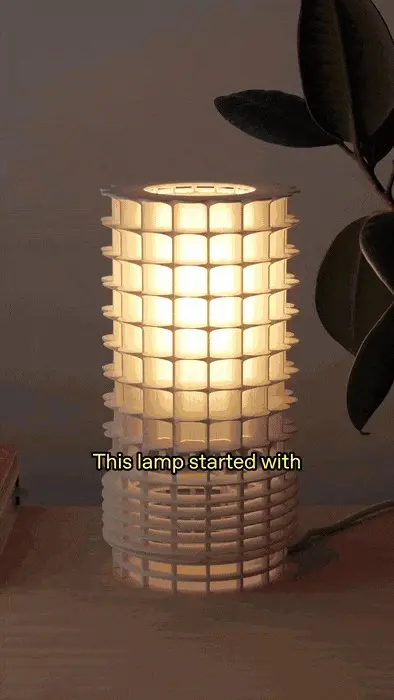
كما ربط اختبار تصميم CAD بالإنتاج الفعلي. قدم فريق OpenAI صورًا للشرفة المروحية الشكل لمبنى مارينا سيتي الشهير في شيكاغو ليسترشد بها النموذج في تصميمه. وبعد عدة تعديلات، أنشأ Astra في النهاية مصباح طاولة فنيًا ورقيًا يمكن طباعته وتجميعه، وكتب صفحة ويب داعمة تسمى Lamp Builder للمستخدمين لضبط المعلمات عبر الإنترنت وإنشاء رسومات مخصصة.
GPT-6.2 Astra يكمل النمذجة الميكانيكية لسيارة الطرق الوعرة التي يتم التحكم فيها عن بُعد والمحرك
في تطوير الويب، أنشأ Astra أداة تخصيص تفاعلية لشاحنة تخييم. يمكن للمستخدمين تبديل لون الهيكل وإضافة خيمة سقف، مع تحديث عرض أسعار الصفحة في الوقت الفعلي. كما أنشأ طاولات بينبول قابلة للعب، ونموذجًا للكولوسيوم الروماني، ولعبة سباق مدينة مستقبلية تسمى "Meridian Sound Racing" بناءً على أوصاف نصية.
من مبنى مارينا سيتي في شيكاغو إلى مصباح الطاولة الورقي الفني
قارن الاختبار الأعمى للتقييم البشري AA-3D من Artificial Analysis أيضًا قدرات النموذج في التوليد ثلاثي الأبعاد. سجل GPT-6.2 Astra 1318 نقطة Elo، محتلاً المركز الأول؛ وسجل Claude Fable 5.2 1271 نقطة، وسجل GPT-6.2 Sol 1259 نقطة.
أداة التخصيص التفاعلية لشاحنة التخييم التي أنشأها GPT-6.2 Astra
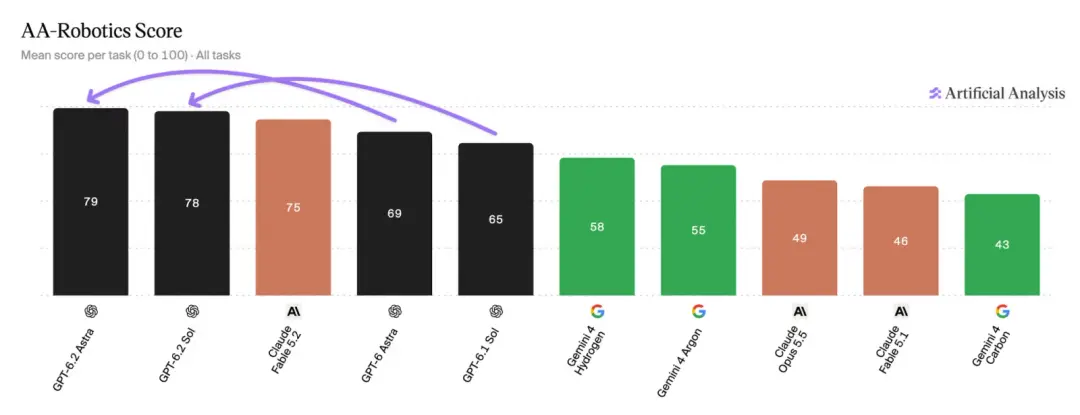
في اختبار AA-Robotics v0.1 الأولي لاختبار فهم العالم المادي وقدرات تخطيط الإجراءات، سجل Astra وSol 79 و78 نقطة على التوالي، متجاوزين 75 نقطة لـ Claude Fable 5.2. ومع ذلك، ذكر فريق التقييم أن النماذج الرائدة أصبحت الآن قادرة على إكمال الغالبية العظمى من المهام الأساسية في الاختبارات الأولية، وهم يزيدون من صعوبة الأسئلة.
04 الاستدلال العلمي وأوجه القصور
كان البحث العلمي أيضًا محورًا رئيسيًا في عرض OpenAI هذه المرة.
في اختبار Terminal-Bench-Science 0.1، تحسن GPT-6.2 Astra بمقدار 9 نقاط مئوية مقارنة بالجيل السابق، محتلاً المركز الأول. يقيم هذا الاختبار بشكل أساسي قدرة النموذج على إكمال سير العمل العلمي في بيئات الطرفية. وفي مؤشر Vals Science Index، الذي يتطلب من النموذج تفسير بيانات بيولوجية حقيقية، وتصميم التجارب، واستنتاج آليات النظام، سجل Astra أيضًا رقمًا قياسيًا جديدًا.
كانت نتائج عدة اختبارات أخرى أدنى قليلاً من Claude Fable 5.2. ففي المجموعة الفرعية عالية الصعوبة من معيار الاستدلال الفيزيائي CritPt v2، وتقييم المعرفة الواقعية AA-Omniscience v1.1، ومعيار الاستدلال HLE-Diamond، احتل Astra المركز الثاني.
إحدى المشكلات التي لا تزال قائمة في النموذج هي أنه قد يقدم إجابات غير صحيحة عند مواجهة حقائق غير يقينية.
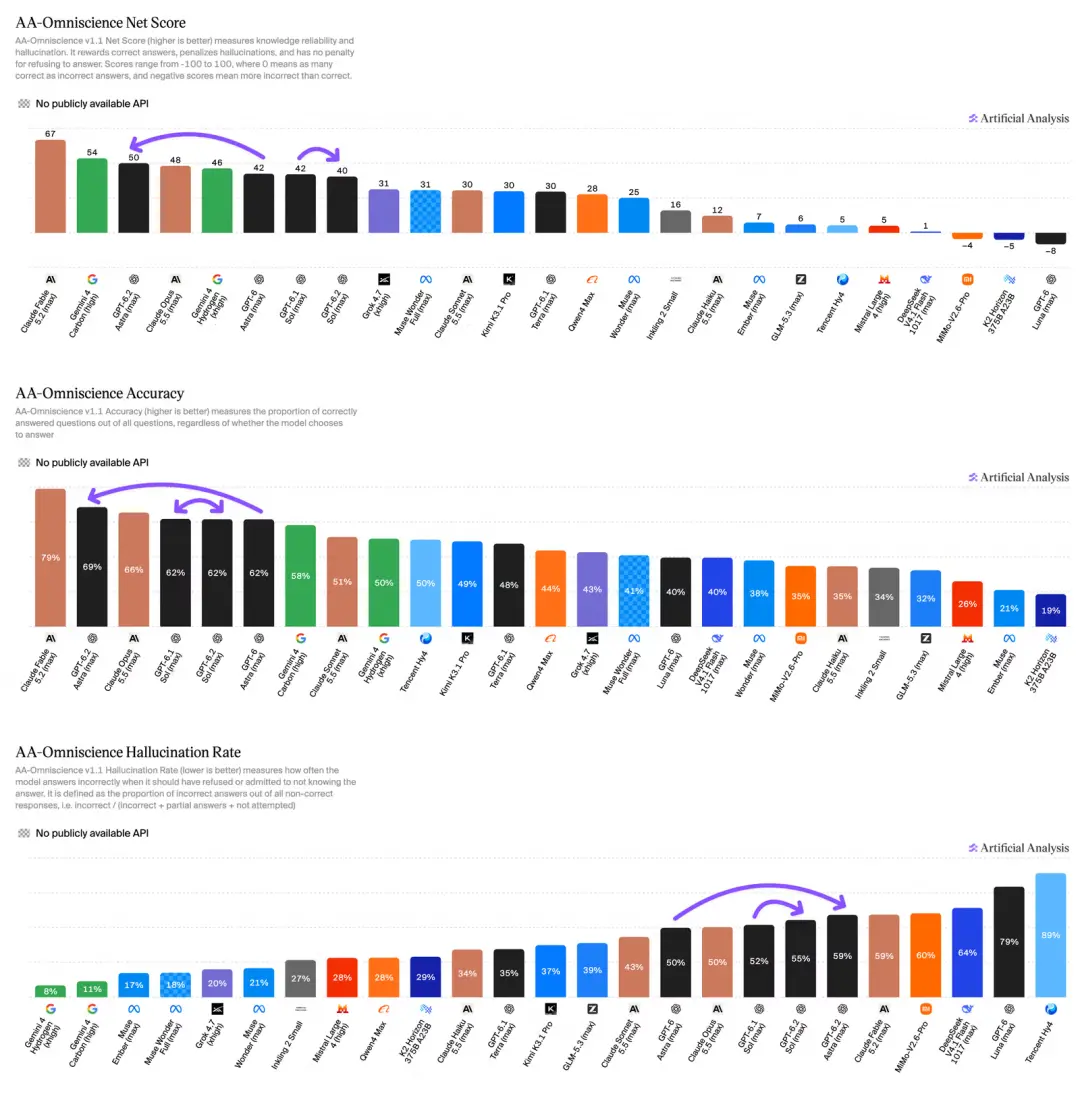
يُظهر اختبار معدل الهلوسة من AA-Omniscience التابع لـ Artificial Analysis أنه عند أعلى كثافة استدلال، تبلغ معدلات الهلوسة لـ GPT-6.2 Astra وSol 59% و55% على التوالي. يفحص هذا الاختبار بشكل أساسي ما إذا كان النموذج يميل إلى تخمين الإجابات عند مواجهة أسئلة واقعية قد لا يملك إجاباتها. وهو لا يمثل معدل خطأ النموذج في الأسئلة والأجوبة العامة، ولكن بالنسبة لسيناريوهات مثل التدقيق المالي والمراجع القانونية، لا يزال التحقق اليدوي ضروريًا.
لم تُظهر اختبارات البرمجة تحسنًا شاملاً أيضًا. ففي مؤشر وكيل البرمجة من Artificial Analysis، تتساوى درجة GPT-6.2 Astra مع سابقتها GPT-6 Astra، بينما انخفض GPT-6.2 Sol بمقدار 3 نقاط مقارنة بـ GPT-6.1 Sol.
تُظهر النتائج التفصيلية أن خسارة درجة Sol تأتي بشكل أساسي من SWE-Atlas-QnA-AA، بانخفاض قدره 14 نقطة. يقيم هذا الاختبار فهم النموذج وقدرته على الأسئلة والأجوبة فيما يتعلق بقواعد التعليمات البرمجية المعقدة. وتشير نتائج الاختبار إلى أن Sol أكثر عرضة لتجاهل الحقائق الأساسية عند الإجابة على الأسئلة المتعلقة بقواعد التعليمات البرمجية مقارنة بسابقه.
هذه نقطة يجب على المطورين الذين يحتاجون إلى التعامل مع أنظمة أكواد موروثة كبيرة الانتباه إليها. يمكن للنموذج كتابة التعليمات البرمجية، لكن هذا لا يعني أنه قد فهم بدقة تاريخ المشروع وتبعياته وقيوده المحددة.
05 حدود الأمان
مع قدرة النموذج على تشغيل الطرفيات ومراجعة التعليمات البرمجية واستدعاء البرامج الاحترافية، زادت مخاطر الأمن السيبراني أيضًا.
كشفت OpenAI أن كلاً من GPT-6.2 Astra وSol قد وصلا إلى "العتبة الحرجة" للأمن السيبراني التي حددها إطار الاستعداد الخاص بالشركة. يمكن لكلا النموذجين اكتشاف واستغلال ثغرات البرمجيات بشكل أكثر كفاءة، بالإضافة إلى كتابة تعليمات برمجية أساسية أكثر أمانًا وإنشاء تصحيحات تحافظ على منطق العمل الأصلي قدر الإمكان.
هذا يعني أن القدرة نفسها يمكن استخدامها لفحص الثغرات وقد تستخدم أيضًا للهجمات. ونتيجة لذلك، عززت OpenAI القيود على النسخة العامة لمهام الأمن السيبراني عالية الخطورة.
بالنسبة للباحثين الأمنيين الذين يحتاجون إلى إجراء اختبار الثغرات، ستؤثر هذه القيود أيضًا على بعض الأعمال العادية. تفتح OpenAI حاليًا القدرات ذات الصلة بشكل متدرج من خلال مشروع Daybreak: يمكن للمدافعين استخدام GPT-6 Sol بمعدل رفض أقل من خلال Daybreak Blue؛ ويمكن لمختبري الفريق الأحمر الحاصلين على ترخيص متقدم استدعاء النسخة ألفا من GPT-6 Astra وGPT-6 Cyber في Daybreak Red. وذكرت OpenAI أن سلسلة GPT-6.2 ستُدمج أيضًا في هذا النظام في المستقبل.
بالإضافة إلى ذلك، أدرجت OpenAI إشارات تدريبية موجهة للدفاع خلال مرحلة التدريب. في السابق، تم استخدام الذكاء الاصطناعي لاكتشاف ثغرات عالية الخطورة مثل PHP2Shell. وتعزز سلسلة GPT-6.2 القدرة على تحديد العيوب الأمنية من مصدر التطوير، وتتعلم إنشاء تصحيحات توازن بين الأمان وسلامة الوظائف.
هذا المحتوى لأغراض معلوماتية وتعليمية فقط، ولا يمثل نصيحة استثمارية تتعلق بـ BTCC. تبذل BTCC قصارى جهدها ولكنها لا تضمن صحة أو دقة أو أصالة المحتوى المذكور أعلاه.